

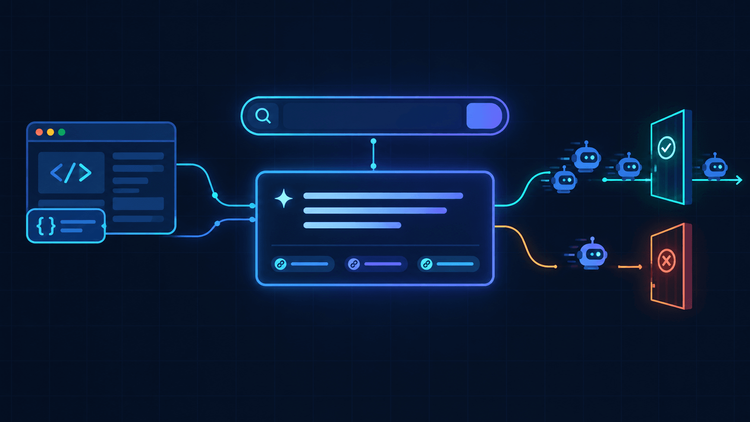
Os resultados da pesquisa agora incluem respostas escritas por IA que citam páginas, e as pessoas cada vez mais pedem recomendações às ferramentas de bate-papo em vez de rolar uma lista de links. Para os desenvolvedores, isso não significa aprender uma nova disciplina. Significa garantir que os princípios básicos estejam implementados para que os rastreadores e mecanismos de resposta possam acessar, ler e citar suas páginas.
A maioria dos problemas são simples erros de engenharia: um rastreador bloqueado, uma página que não renderiza nada sem JavaScript ou uma marcação que discorda do texto visível. Este artigo cobre sete verificações, incluindo um script que você pode executar em seu próprio robots.txt.
1. Certifique-se de que a página pode ser indexada
Os recursos de IA na pesquisa não precisam de um arquivo ou formato especial. Documentação do Google sobre Recursos de IA e seu site afirma que uma página precisa ser indexada e qualificada para aparecer na Pesquisa com um snippet e que não há requisitos técnicos adicionais. Também diz que não há necessidade de novos arquivos específicos de IA ou especiais esquema.org marcação.
Então comece com os fundamentos. Verifique se há acidente noindex tags após uma implantação, confirme se páginas importantes retornam o status 200 e certifique-se de que as configurações de teste nunca cheguem à produção.
2. Mantenha o conteúdo importante no texto
Os mecanismos de resposta leem o texto. Se suas informações principais residirem em imagens, elementos de tela ou conteúdo que só aparece após a execução de um script do lado do cliente, um rastreador poderá nunca vê-las. Visualize o código-fonte da página e o HTML renderizado e compare-os. Nomes de produtos, preços, definições e etapas devem estar presentes como texto real.
3. Faça com que os dados estruturados correspondam à página
Os dados estruturados ajudam os sistemas a compreender uma página, mas apenas se concordarem com o que os visitantes veem. Guia do SitePoint para JSON-LD para desenvolvedores mostra como construir marcações que os sistemas de pesquisa e IA podem analisar. Gere-o a partir dos mesmos dados que renderizam a página e valide-o após cada alteração do modelo. A marcação que contradiz o texto visível é pior do que nenhuma marcação.
4. Decida o acesso do rastreador propositalmente
Seu robots.txt decide quais rastreadores podem buscar suas páginas. Alguns sites bloqueiam rastreadores de IA deliberadamente e outros os bloqueiam acidentalmente por meio de uma regra ampla. O guia técnico do SitePoint para trabalhando com uma agência de marketing lista as decisões do robots.txt sobre quais rastreadores podem acessar o site entre as verificações que os desenvolvedores devem possuir.
Esta pequena função lê uma string robots.txt e relata quais rastreadores comuns relacionados à IA estão bloqueados em todo o site:
javascript
const AI_BOTS = ("GPTBot", "ClaudeBot", "PerplexityBot", "Google-Extended");

function blockedBots(robotsTxt) {
  const blocked = ();
  let agents = ();
  let lastWasAgent = false;

  for (const raw of robotsTxt.split("\n")) {
    const line = raw.split("#")(0).trim();
    if (!line) continue;
    const (key, ...rest) = line.split(":");
    const field = key.trim().toLowerCase();
    const value = rest.join(":").trim();

    if (field === "user-agent") {
      if (!lastWasAgent) agents = ();
      agents.push(value);
      lastWasAgent = true;
      continue;
    }
    lastWasAgent = false;

    if (field === "disallow" && value === "/") {
      for (const bot of AI_BOTS) {
        const hit = agents.some((a) => a === "*" || a === bot);
        if (hit && !blocked.includes(bot)) blocked.push(bot);
      }
    }
  }
  return blocked;
}
Execute-o em seu robots.txt ativo. Se um rastreador aparecer na lista e você não pretendia fazer isso, corrija a regra. Observe que bloquear um rastreador é uma escolha legítima. O objetivo é que seja uma decisão e não um acidente.
5. Obtenha uma avaliação externa de sua aparência
Os desenvolvedores podem verificar o acesso e a marcação, mas julgar como uma marca aparece nas respostas de IA geralmente precisa de alguém que monitore essa área em tempo integral. Um consultor de pesquisa de IA como Austin Heaton trabalha na otimização do mecanismo de resposta. A página vinculada é a página inicial comercial de um consultor, portanto, verifique quaisquer reivindicações sobre ela de forma independente e compare qualquer conselho com o que você pode medir em seu próprio site.
6. Avalie o que você puder
O tráfego dos recursos de IA na Pesquisa Google está incluído no relatório de desempenho do Search Console no tipo de pesquisa na Web. Configure esse relatório, marque suas próprias campanhas com parâmetros UTM consistentes e observe o tráfego de referência das ferramentas de chat em suas análises. Você não pode controlar as respostas, mas pode ver se os cliques chegam.
7. Verifique novamente após cada lançamento
A maioria dos problemas de visibilidade aparece após uma implantação: uma alteração no modelo elimina os dados estruturados, uma nova regra bloqueia um rastreador ou uma reformulação oculta o texto atrás de um script. Adicione um pequeno teste pós-implantação para as verificações acima. Uma falha na verificação do robots.txt ou um bloco JSON-LD ausente deve interromper o lançamento antes que um rastreador encontre o problema.
Perguntas frequentes
Preciso de um arquivo llms.txt ou de uma marcação especial para pesquisa de IA? A documentação do Google diz que nenhum novo arquivo específico de IA ou dados estruturados especiais são necessários para seus recursos de IA. Aplicam-se requisitos padrão de indexação e rastreamento.
Devo bloquear rastreadores de IA? Isso depende de seus objetivos. O bloqueio é uma escolha legítima, mas faça-o deliberadamente e revise-o regularmente.
Onde vejo o tráfego de pesquisa de IA? Para o Google, o tráfego de recursos de IA é contado no relatório de desempenho do Search Console no tipo de pesquisa na Web. Outras ferramentas aparecem como referências em suas análises.
Resumo
Tornar um site legível para pesquisa de IA é basicamente uma engenharia comum: manter as páginas indexáveis, colocar o conteúdo principal no texto, manter os dados estruturados consistentes, decidir o acesso do rastreador propositalmente, medir o que puder e testar novamente após cada lançamento. A verificação do robots.txt acima é pequena, mas detecta um dos bloqueios acidentais mais comuns antes de custar visibilidade.
