


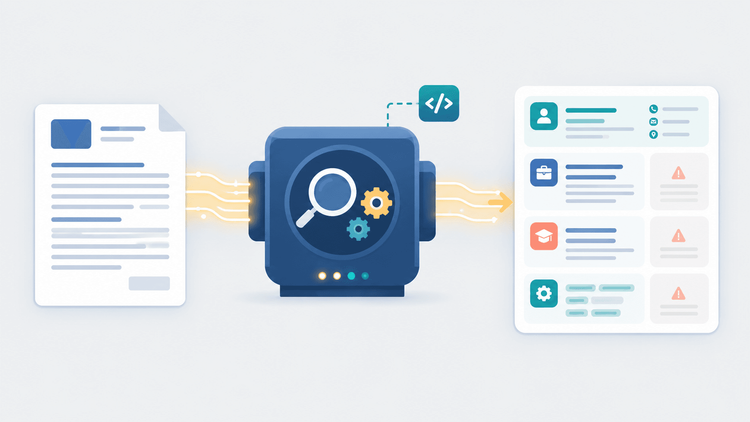
Um currículo que parece perfeito na tela pode parecer uma pilha de texto embaralhado em um programa. Os sistemas de rastreamento de candidatos (ATS) e as ferramentas de contratação não veem seu layout. Eles extraem texto de um arquivo, adivinham onde estão as seções e armazenam o que encontram. Se essa etapa falhar, a melhor experiência do mundo nunca chegará ao leitor humano.
Isso é importante se você está enviando seu próprio currículo ou construindo uma ferramenta que processa milhares deles. Este artigo aborda sete verificações que você pode fazer com algumas linhas de Python, incluindo um script que você pode executar hoje.
1. Trate o currículo como dados não estruturados
O currículo é um documento sem estrutura garantida. Uma pessoa escreve “Histórico de Trabalho”, outra escreve “Experiência” e uma terceira usa um layout de duas colunas que lê fora de ordem. Qualquer ferramenta que processe currículos primeiro deve transformá-los em campos previsíveis: detalhes de contato, seções, datas e habilidades.
Pensar em termos de um esquema de destino ajuda. Artigo do SitePoint sobre Design de esquema JSON para documento AI mostra como a estrutura dos rótulos definidos determina se um pipeline de documentos funciona. A mesma ideia se aplica aqui: decida quais campos você precisa antes de escrever qualquer código de extração.
Não julgue um currículo pela aparência. Julgue pelo que sai quando você extrai o texto. Passo a passo do SitePoint em construindo um conjunto de dados JSON a partir de documentos PDF descreve um pipeline que extrai texto de PDFs e depois limpa artefatos de extração comuns. Essa etapa de limpeza existe porque a extração bruta raramente é organizada. Leia a saída bruta primeiro e observe o que está quebrado.
Os arquivos PDF armazenam onde os caracteres são colocados em uma página, não o que eles significam. A documentação pypdf em extraindo texto de um PDF diz isso diretamente: não há camada semântica, é difícil acertar o espaçamento porque o texto está posicionado de forma absoluta e o pypdf não é um software de OCR, portanto, nunca extrairá texto de imagens.
Seguem dois resultados práticos. Um currículo salvo como imagem digitalizada não contém nenhum texto extraível. E layouts sofisticados, como colunas, caixas de texto e tabelas, podem aparecer na ordem errada.
4. Verifique o básico automaticamente
Depois de extrair o texto, um pequeno script pode detectar as falhas comuns. Este lê um PDF e informa se ele contém texto, se um endereço de e-mail foi encontrado e quais seções padrão estão faltando:
píton
import re
from pypdf import PdfReader

SECTIONS = ("experience", "education", "skills")


def check_resume(path):
    reader = PdfReader(path)
    text = "\n".join(page.extract_text() or "" for page in reader.pages)
    lower = text.lower()

    return {
        "has_text": len(text.strip()) > 50,
        "email_found": bool(re.search(r"(\w.+-)+@(\w-)+\.\w+", text)),
        "missing_sections": (s for s in SECTIONS if s not in lower),
    }
Execute-o em um currículo e veja o resultado. Se has_text for falso, o arquivo provavelmente é uma imagem. Se faltarem seções, verifique se seus títulos usam nomes incomuns. Um resultado aprovado não prova que todo ATS lerá o arquivo da mesma maneira, mas um resultado reprovado é um aviso claro.
5. Compare seu resultado com um verificador externo
Ferramentas diferentes analisam de maneira diferente, portanto, um script é apenas uma opinião. Um serviço de redação de currículos, como CurrículoCroc lista um verificador de currículo ATS gratuito entre suas ferramentas, que é uma maneira rápida de ver como outra ferramenta lê o mesmo arquivo. A página vinculada é uma página de serviço comercial e cada ATS se comporta de maneira diferente; portanto, trate qualquer verificador como um ponto de dados e compare-o com seus próprios resultados de extração.
6. Mantenha a formatação simples
A maioria dos problemas de extração vem do layout. Páginas de coluna única, títulos padrão, fontes simples e texto real em vez de imagens dão aos analisadores a melhor chance. Evite colocar detalhes de contato em cabeçalhos ou rodapés, pois algumas ferramentas os ignoram. Se você estiver construindo um analisador, teste arquivos com colunas e tabelas propositalmente para saber como sua ferramenta falha.
7. Mantenha um pequeno conjunto de arquivos de teste
Crie uma pasta com exemplos de currículos: um limpo, um de duas colunas, um digitalizado e outro com títulos incomuns. Execute sua verificação em todos eles sempre que alterar seu código de análise. Isso transforma “parece funcionar” em algo que você pode verificar e torna as regressões óbvias.
Perguntas frequentes
Todos os sistemas de rastreamento de candidatos leem PDFs da mesma maneira? Não. Os analisadores diferem na forma como lidam com layout, cabeçalhos e tabelas, portanto, teste mais de um formato de arquivo e mais de uma ferramenta.
Um arquivo Word é mais seguro que um PDF? Não necessariamente. Ambos podem analisar bem ou mal, dependendo do layout. Teste seu próprio arquivo em vez de assumir.
Um script pode garantir que meu currículo será aprovado no ATS? Não. Um script pode encontrar problemas óbvios, como falta de texto ou títulos, mas cada ferramenta de contratação tem suas próprias regras.
Resumo
As ferramentas de contratação leem o texto, não o layout. Defina os campos de seu interesse, extraia primeiro o texto bruto, entenda o que a extração de PDF não pode fazer, automatize verificações básicas, compare com um verificador externo, mantenha a formatação simples e teste em um pequeno conjunto de arquivos de amostra. O script acima é curto, mas move a questão de “parece certo” para “o que um programa realmente vê”.
