


Um estudo de 713 incidentes e 249 ações judiciais mostra onde os danos da IA estão chegando primeiro e por que os clientes implantadores dos corretores mal se registram nos dados ainda
Apesar de toda a conversa sobre algoritmos descontrolados, o registro inicial de que a inteligência artificial deu errado parece menos ficção científica e mais uma caixa de entrada de tablóide e uma lista de direitos autorais.
Esse é o quadro pintado por A segurabilidade da inteligência artificialum relatório revisado por pares publicado em 16 de setembro pela RAND Corporation.
Os pesquisadores Sasha Romanosky e Celine Robinson vasculharam registros públicos de incidentes, litígios de IA, leis estaduais promulgadas e registros de apólices de mercado admitidas, depois entrevistaram especialistas jurídicos e de seguros para descobrir que tipo de risco as seguradoras estão realmente sendo solicitadas a assumir.
A resposta deles: a IA já causou muitos danos, mas até agora a maior parte deles envolve conteúdo falso e lutas por direitos autorais, em vez de falhas operacionais com as quais muitos segurados se preocupam. A evidência acompanha a conclusão mais ampla da RAND, abordada em Negócio de seguros no início deste mês, que a maioria das operadoras permanece em silêncio sobre IA em suas formulaçõesdeixando a cobertura aberta a disputa.
Pelos números
- 84% de 713 incidentes generativos de IA envolveram desinformação ou deepfakes
- 60% de 249 ações judiciais de IA generativa nos EUA dizem respeito a direitos autorais ou dados de treinamento
- 62 estado leis em 33 estados têm como alvo imagens íntimas geradas por IA ou material de abuso infantil
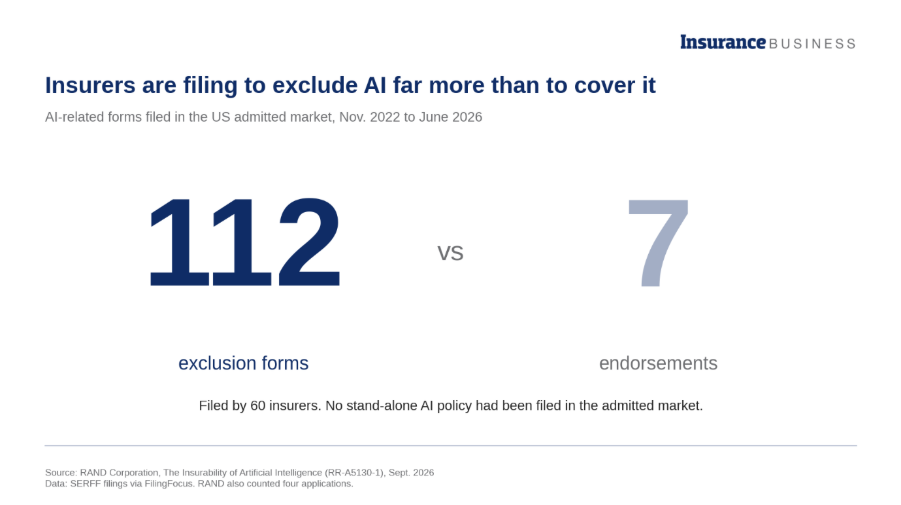
- 112 contra 7: Formulários de exclusão de IA versus endossos arquivados no mercado admitido
Conteúdo falso domina o registro de incidentes
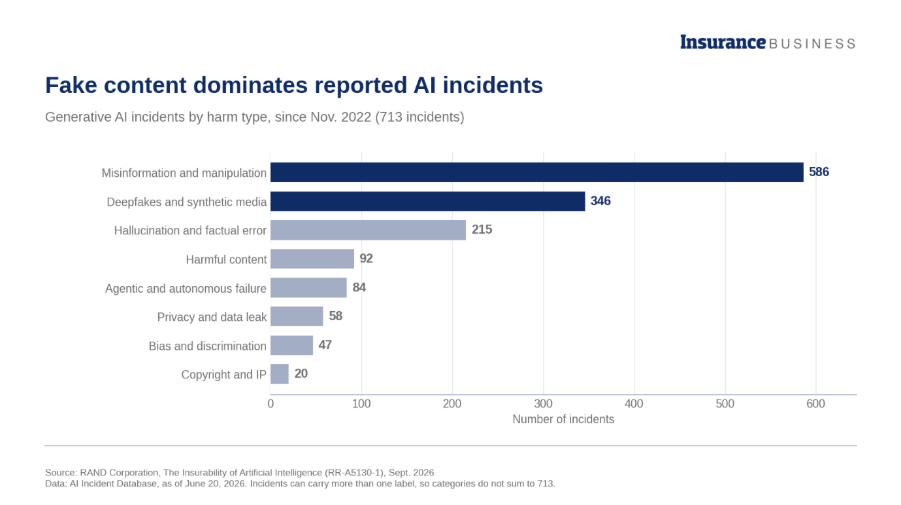
Os pesquisadores aproveitaram o trabalho voluntário Banco de dados de incidentes de IAisolando 713 incidentes generativos de IA registrados desde o lançamento do ChatGPT em novembro de 2022. Desses, 599, ou cerca de 84%, envolveram desinformação ou deepfakes.
Áudios fabricados de políticos, vozes clonadas, golpes baseados em textos e imagens sintéticas. As duas categorias sobrepõem-se fortemente, com mais de metade dos casos de desinformação a depender de meios de comunicação totalmente sintéticos para enganar.
O áudio foi o meio mais comum, aparecendo em cerca de um terço dos incidentes, à frente do vídeo, em cerca de um quarto.
As falhas mais “operacionais” que mantêm os gestores de risco acordados à noite estão presentes, mas ficam bem atrás. Alucinações e erros factuais apareceram em 215 incidentes, cerca de 30%. Resultados prejudiciais ou inseguros foram responsáveis por 92. Falhas de agente, onde um sistema de IA realiza uma ação não intencional no mundo real, totalizaram 84. Um caso amplamente divulgado nesta primavera envolveu um agente de codificação que, de acordo com o fundador da empresa, excluiu o banco de dados de produção de uma empresa de software e seus backups em segundos.
Os autores alertam que a base de dados é de crowdsourcing e não é totalmente validada, pelo que sinaliza a forma dos danos da IA em vez da sua verdadeira frequência.
Leia a seguir: Como o Mythos da Anthropic está alimentando temores de agregação de riscos cibernéticos
O tribunal conta uma história diferente
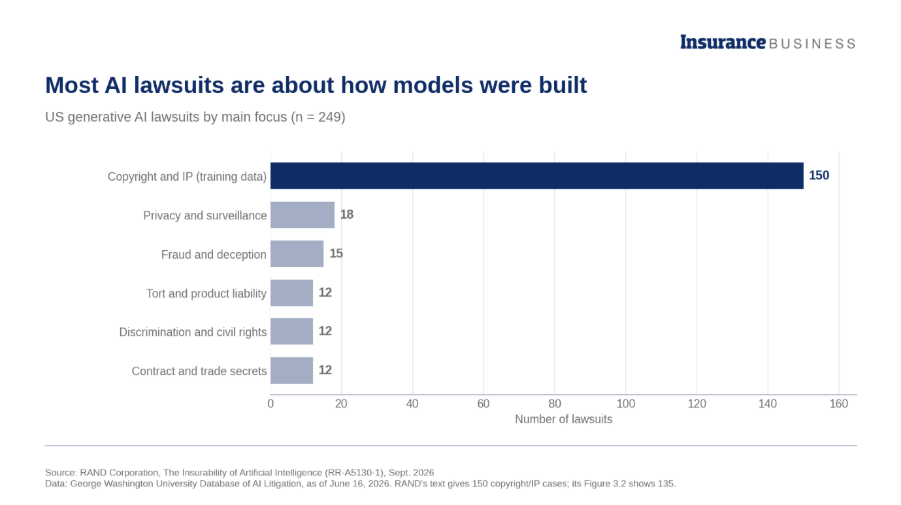
Se os incidentes são principalmente sobre conteúdo falso, os processos judiciais são principalmente sobre dados de treinamento. Usando o da Universidade George Washington Banco de dados de litígios de IAa RAND examinou 249 casos de IA generativa nos EUA e descobriu que 150, ou 60%, dizem respeito a alegadas violações de direitos de autor ou de propriedade intelectual na forma como os modelos foram construídos, e não na forma como foram utilizados. O exemplo mais conhecido é o processo do New York Times contra a OpenAI e a Microsoft pelo uso de seus artigos para treinar chatbots.
Isso é importante para os subscritores porque esses casos visam principalmente os desenvolvedores de IA, os laboratórios de fronteira, que normalmente tentam limitar a sua exposição através de contratos.
Os negócios que os corretores realizam todos os dias são geralmente implantadores, empresas que conectam IA ao atendimento ao cliente, contratação, empréstimo ou subscrição. A RAND argumenta que os implantadores podem, em última análise, ser os mais expostos a danos operacionais, regulatórios e para o usuário final, mas eles mal são registrados nas contagens de litígio atuais.
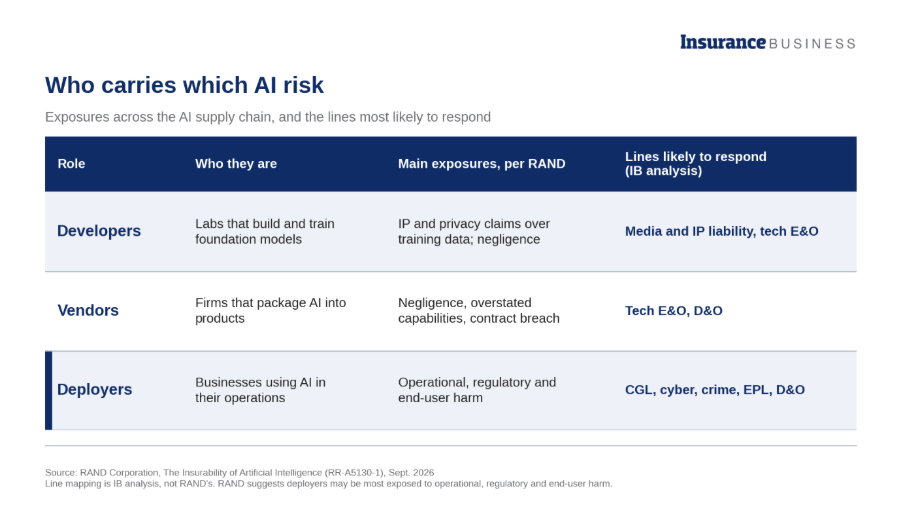
Os baldes menores sugerem o que pode estar por vir. A RAND contou 18 processos de privacidade e vigilância, 15 casos de fraude e engano, incluindo alegações de “lavagem de IA” por executivos que exageraram as capacidades dos seus produtos, e 12 reclamações de responsabilidade civil e de responsabilidade civil do produto, entre elas processos de homicídio culposo contra fabricantes de chatbots. Cada um deles mapeia uma linha familiar: responsabilidade cibernética e de privacidade, FAZERe produtos ou responsabilidade geral.
Os legisladores estaduais estão perseguindo as mesmas falsificações
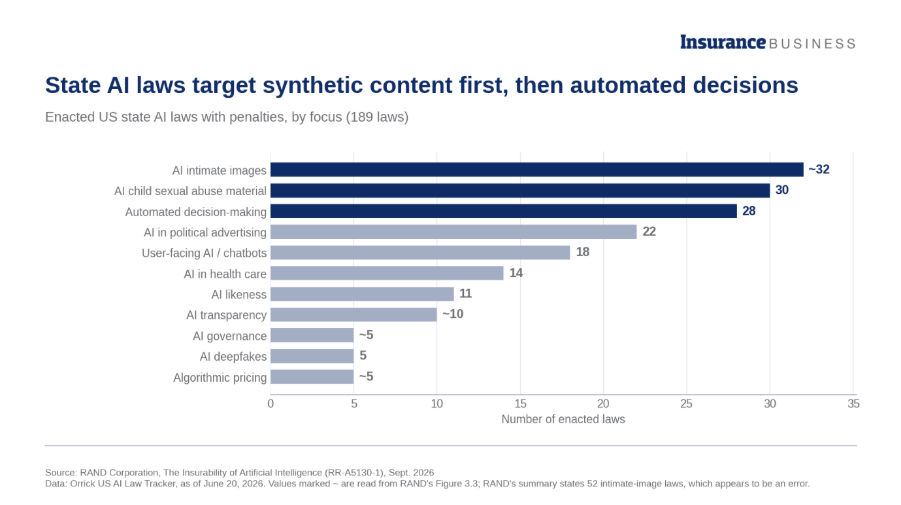
As legislaturas estaduais reagiram à mesma enxurrada de conteúdo sintético. Das 189 leis estaduais de IA promulgadas com penalidades que a RAND revisou, usando o escritório de advocacia Orrick’s Rastreador de leis de IA dos EUAo maior grupo tem como alvo imagens íntimas não consensuais e material de abuso sexual infantil gerado por IA, com 62 leis desse tipo em 33 estados.
Uma segunda onda é direcionada diretamente aos usuários comerciais. A RAND contou 28 leis sobre tomada de decisão automatizada, abrangendo direitos de exclusão, avaliações de impacto e auditorias tendenciosas na contratação, além de 18 leis que regem chatbots voltados para o cliente e 14 que restringem a IA nas decisões de cobertura de cuidados de saúde. Tanto para os empregadores como para as seguradoras, estas são as regras com maior probabilidade de gerar reclamações sobre práticas regulamentares e laborais.
Leia a seguir: Por que a estratégia de IA em seguros deve começar com resultados: Centro de Justiça Econômica
Por que a IA não é apenas o próximo ciberespaço
É tentador tratar a IA como a irmã mais nova do seguro cibernético. A RAND argumenta que isso seria um erro. A maioria das reclamações cibernéticas são custos primários desencadeados por um ataque identificável, enquanto a maioria das perdas de IA até agora são reclamações de terceiros, muitas vezes de um sistema que faz o que foi construído para fazer, mas mal.
Isso afasta a subscrição dos firewalls e das correções em direção à governança, como a validação de modelos e a revisão humana dos resultados, e torna a causalidade mais difícil de definir.
O resultado prático é que um único evento de IA pode afetar uma dúzia de políticas. RAND reproduz um Aon mapeamento dos perigos da IA contra 11 linhas potenciais, desde a responsabilidade dos meios de comunicação social e E&O tecnológica até ao crime e às práticas laborais.
Os corretores já viram as seguradoras agirem para reduzir essa expansão, com algumas operadoras eliminando fraude deepfake de cobertura de engenharia social nas renovações de janeiro, enquanto outros o comercializam como uma extensão afirmativa.
Preços no escuro
Os subscritores normalmente resolveriam essas questões com dados de sinistros. Quase não há nenhum.
A RAND observa que os dados públicos de reivindicações de IA são efetivamente inexistentes, os processos judiciais levam anos para serem resolvidos e o mesmo modelo configurado da mesma maneira pode falhar de maneiras diferentes. Os benchmarks e os questionários de governação ajudam, dizem os autores, mas as taxas de erro medidas podem deixar passar as raras falhas que custam mais.
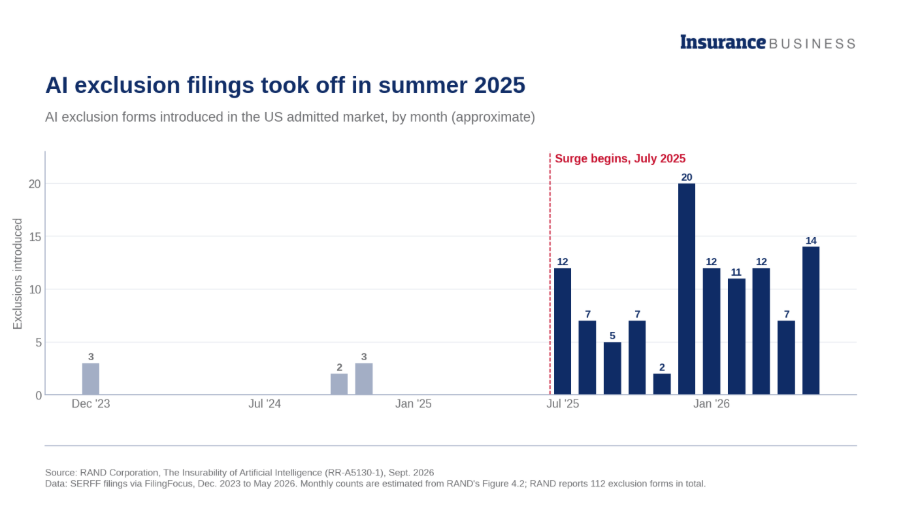
A resposta previsível é cautela: termos mais restritos, retenções mais elevadas, limites mais baixos e mais exclusões. Os registros do mercado admitido confirmam isso. Dos formulários relacionados à IA que a RAND extraiu dos sistemas de arquivamento estaduais, 112 eram exclusões de apenas sete endossos, apresentados por 60 seguradoras.
O relatório acrescenta que nenhuma política de IA independente havia sido apresentada no mercado admitido no momento em que este artigo foi escrito, deixando a cobertura afirmativa em grande parte para jogadores especializados e não admitidos, uma lacuna que subscritores delegados estão observando de perto.
Leia a seguir: O seguro depende totalmente da IA, mas as bases são instáveis
A compensação que ninguém pode medir ainda
A RAND enquadra a escolha do mercado como uma gangorra. Quanto mais as operadoras de perdas de IA cobrem afirmativamente, menor será a lacuna de proteção para as empresas, mas mais correlacionadas as seguradoras de exposição assumem. As exclusões fazem o inverso. O silêncio, a postura mais comum, é a pior de ambas, porque esconde o tamanho da lacuna e o tamanho do acúmulo.
O relatório é sincero ao afirmar que ainda não existem dados para estimar qualquer um dos números. A sua solução é menos glamorosa do que um novo produto: uma taxonomia partilhada para registar incidentes de IA, sinistros e controlos em vigor no momento da perda, construída por corretores, transportadores, resseguradores e investigadores, com os dados de cada empresa mantidos privados. Paralelamente, a RAND quer que os reguladores estaduais e o Associação Nacional de Comissários de Seguros para desenvolver um aviso de cobertura de IA padrão e para as operadoras testarem cenários de estresse, como uma atualização defeituosa de um modelo amplamente utilizado ou uma decisão judicial que repentinamente torna uma prática comum de IA acionável.
Os autores evitam pedir regras federais, e esse debate ainda está vivo. Uma ordem executiva de dezembro de 2025 determina que as agências federais desafiem as leis estaduais de IA, mas até o final de setembro nenhuma lei estadual havia sido derrubada e o Congresso não havia aprovado legislação de preempção, de acordo com um rastreador da implementação da ordem.
Para os corretores, a conclusão de curto prazo é mais simples. As perdas que os clientes provavelmente enfrentarão primeiro não são robôs com defeito, mas falsificação de identidade, fraude, responsabilidade pelo conteúdo e as consequências regulatórias de decisões automatizadas. Esses já estão, desconfortavelmente, dentro das políticas que os clientes possuem hoje. Conforme reportagem anterior sobre responsabilidade oculta da IA dentro das políticas convencionais mostrou, descobrir quais respondem agora faz parte da conversa de renovação.
Leia a seguir: Relatório: As empresas pressionam por cobertura de seguro à medida que os riscos da GenAI se multiplicam
