


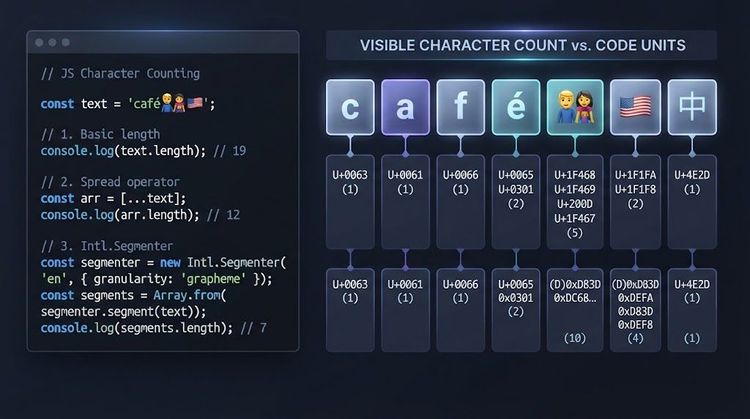
Por que string.lengthemoji, agrupamentos de grafemas e Intl.Segmenter pode tornar um contador de caracteres “simples” surpreendentemente complicado.
Por Mohsin
Um contador de caracteres JavaScript parece um recurso de cinco minutos.
const count = text.length;
Para texto simples em inglês, isso parece funcionar perfeitamente.
Então alguém cola um emoji.
Ou uma bandeira. Ou um personagem com sotaque. Ou um emoji de família unido a partir de vários pontos de código Unicode.
O número na tela não corresponde mais ao que a pessoa vê.
Encontrei isso enquanto trabalhava com transformações de texto Unicode baseadas em navegador. A parte surpreendente não foi que o Unicode seja complicado; foi por quanto tempo uma suposição quebrada pode permanecer oculta quando cada string de teste é apenas “Olá, mundo”.
A questão central é que a palavra personagem pode descrever várias coisas diferentes em JavaScript: unidades de código UTF-16, pontos de código Unicode ou clusters de grafemas – os caracteres percebidos pelo usuário exibidos na tela.
Se você criar entradas de texto, limites de nome de usuário, editores, interfaces de bate-papo, ferramentas sociais ou qualquer interface que aceite texto internacional, escolher a unidade errada pode produzir contagens incorretas, truncamento quebrado e validação inconsistente.
Veja como lidar corretamente com a contagem de caracteres JavaScript e como decidir qual definição de “caractere” seu produto realmente precisa.
Por que string.length Pode enganar você
Comece com uma string normal:
const text = "hello";

console.log(text.length);
Até agora tudo bem.
Agora tente um emoji:
const text = "😀";

console.log(text.length);
O usuário vê um símbolo.
JavaScript relata dois.
Isso ocorre porque as strings JavaScript usam UTF-16. Alguns caracteres Unicode cabem em uma unidade de código de 16 bits, enquanto outros são representados como um par substituto.
String.prototype.length conta unidades de código UTF-16, não caracteres visíveis.
Esse comportamento é correto de acordo com o idioma. Só é errado quando o rótulo da UI diz “caracteres”, mas o produto realmente significa “o que o usuário vê”.
Três coisas diferentes que os desenvolvedores chamam de personagem
Para manipulação de texto frontend, é útil separar essas três camadas.
| Unidade | Abordagem JavaScript | O que mede |
|---|---|---|
| Unidades de código UTF-16 | text.length |
Unidades de string internas do JavaScript |
| Pontos de código Unicode | (...text).length |
Valores escalares Unicode individuais |
| Aglomerados de grafemas | Intl.Segmenter |
Personagens percebidos pelo usuário |
Para ASCII básico ou texto em inglês comum, todas as três contagens são frequentemente idênticas.
É por isso que um bug no contador de caracteres pode sobreviver aos testes por meses.
As diferenças aparecem nos emojis, combinando marcas, bandeiras, modificadores de tom de pele e muitos sistemas de escrita não latinos.
Um primeiro passo melhor: iterar por ponto de código Unicode
Uma melhoria comum é parar de usar:
text.split("")
e use o iterador de string:
(...text)
Por exemplo:
const text = "😀";

console.log(text.split("").length);


console.log((...text).length);
O operador spread itera pontos de código Unicode em vez de dividir cegamente as unidades de código UTF-16.
Array.from() usa o mesmo comportamento do iterador:
const chars = Array.from(text);

console.log(chars.length);
Isto é especialmente útil em código de transformação de texto.
Se você estiver mapeando caracteres para formulários Unicode alternativos, isto:
(...text).map(...)
é muito mais seguro do que:
text.split("").map(...)
porque não divide caracteres suplementares em metades substitutas.
Mas os pontos de código ainda não são a mesma coisa que caracteres visíveis.
Por que um símbolo visível pode conter vários pontos de código
Considere um emoji de família:
const text = "👨👩👧👦";
console.log((...text).length);
Uma pessoa vê um emoji.
A string contém vários pontos de código unidos em um grafema exibido.
As bandeiras têm o mesmo tipo de surpresa:
const text = "🇺🇸";

console.log((...text).length);
A bandeira dos EUA é composta por dois pontos de código de indicadores regionais, embora a interface renderize uma bandeira.
O texto acentuado também pode ter mais de uma representação interna válida:
const composed = "é";
const decomposed = "e\u0301";

console.log(composed);
console.log(decomposed);
Eles podem parecer idênticos embora contenham sequências Unicode diferentes.
Para limites voltados ao usuário, a unidade que você normalmente deseja é o cluster de grafema – aproximadamente, o personagem que uma pessoa percebe e edita como uma unidade.
A documentação de internacionalização JavaScript do MDN é uma referência útil para os conceitos circundantes:
https://developer.mozilla.org/en-US/docs/Web/JavaScript/Guide/Internationalization
Conte caracteres percebidos pelo usuário com Intl.Segmenter
O JavaScript moderno nos fornece uma API nativa para isso: Intl.Segmenter.
const segmenter = new Intl.Segmenter(undefined, {
  granularity: "grapheme"
});

function countCharacters(text) {
  return (...segmenter.segment(text)).length;
}
Agora os resultados estão muito mais próximos do que o usuário espera:
console.log(countCharacters("hello"));
console.log(countCharacters("😀"));
console.log(countCharacters("🇺🇸"));
console.log(countCharacters("👨👩👧👦"));
Intl.Segmenter pode segmentar texto por grafema, palavra ou frase.
Para um contador de caracteres JavaScript seguro para emojis, esta é a opção importante:
granularity: "grapheme"
Para suporte do navegador e detalhes da API, consulte MDN’s Intl.Segmenter referência:
https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/Intl/Segmenter
Um ajudante prático de contador de caracteres
Prefiro manter a lógica de segmentação em um auxiliar em vez de repeti-la dentro de cada evento de entrada.
const graphemeSegmenter =
  typeof Intl !== "undefined" && Intl.Segmenter
    ? new Intl.Segmenter(undefined, {
        granularity: "grapheme"
      })
    : null;

function getCharacterCount(text) {
  if (graphemeSegmenter) {
    return (...graphemeSegmenter.segment(text)).length;
  }

  return (...text).length;
}
Então o código da UI permanece pequeno:
const input = document.querySelector("#message");
const counter = document.querySelector("#counter");

input.addEventListener("input", () => {
  const count = getCharacterCount(input.value);

  counter.textContent = `${count} / 280`;
});
O substituto conta pontos de código em vez de clusters de grafemas, portanto não é idêntico.
Ainda assim, evita o problema mais óbvio do par substituto em ambientes onde Intl.Segmenter está indisponível.
Os limites de caracteres são uma regra de produto, não apenas uma regra de JavaScript
Suponha que um campo de perfil permita 20 caracteres.
O que 20 realmente significa?
Poderia significar:
- 20 unidades de código UTF-16
- 20 pontos de código Unicode
- 20 clusters de grafemas
- 20 bytes em uma codificação específica
- 20 caracteres de acordo com um banco de dados ou regra de API
Esses limites não são intercambiáveis.
Um contador de nome de exibição geralmente parece mais natural quando conta clusters de grafemas.
Um índice de banco de dados, carga útil de SMS, campo de protocolo ou validador de backend pode ter uma restrição técnica completamente diferente.
O front-end deve explicar a regra voltada ao usuário, mas também precisa validar o mesmo limite rígido que o back-end realmente impõe.
A normalização Unicode resolve um problema diferente
Respostas de segmentação:
Onde termina um personagem percebido pelo usuário?
A normalização responde a uma pergunta diferente:
Quando duas sequências Unicode devem ser tratadas como equivalentes?
Considerar:
const a = "é";
const b = "e\u0301";

console.log(a === b);
Eles podem renderizar o mesmo enquanto comparam strings diferentes.
JavaScript fornece String.prototype.normalize():
console.log(
  a.normalize("NFC") === b.normalize("NFC")
);
Unicode define quatro formas principais de normalização:
NFC é comumente útil quando você deseja que texto canonicamente equivalente seja representado de forma consistente.
A normalização de compatibilidade, como NFKC, vai além e pode destruir intencionalmente as distinções entre caracteres de compatibilidade.
O Anexo Padrão Unicode sobre normalização explica essas diferenças em detalhes:
https://www.unicode.org/reports/tr15/
Tenha cuidado com o NFKC em fluxos de trabalho Unicode decorativos ou com estilo.
A normalização de compatibilidade pode alterar caracteres que foram selecionados especificamente para sua aparência alternativa.
Por exemplo:
const normalized = text.normalize("NFKC");
não deve ser adicionado a um pipeline de texto simplesmente porque a normalização parece mais segura.
Primeiro decida qual equivalência seu aplicativo realmente precisa.
Unicode estilizado é um teste de estresse de front-end útil
As ferramentas de texto Unicode são excepcionalmente boas para expor suposições fracas porque combinam letras comuns com alfabetos matemáticos, símbolos, emoji, marcas de combinação e caracteres decorativos.
Enquanto trabalhava Gerador de fontes ao vivo:
https://livefontgenerator.com/
Descobri que strings de teste mais variadas revelam rapidamente problemas que nunca aparecem com ASCII simples.
Isso torna o Unicode estilizado útil mesmo se o seu produto de produção não for um gerador de fontes.
Um desenvolvedor pode testar isso:
Hello world
e conclua que a lógica de contagem, truncamento, cópia e visualização está correta.
Então teste algo como:
Hello 👨👩👧👦 🇺🇸 é नमस्ते
e vários casos extremos aparecem imediatamente.
A lição é simples:
Use dados de teste que desafiem suas suposições, não apenas dados que façam o caminho feliz passar.
O truncamento pode ser interrompido pelo mesmo motivo
A contagem de caracteres é apenas metade do problema.
O truncamento pode dividir as mesmas sequências Unicode.
Esse:
const shortened = text.slice(0, 10);
fatia unidades de código UTF-16.
Isto é melhor:
const shortened = (...text)
  .slice(0, 10)
  .join("");
mas ainda corta pontos de código, então um cluster de grafema pode ser cortado no meio.
Para truncamento de caracteres visíveis, segmente primeiro:
function truncateGraphemes(text, maxLength) {
  const segmenter = new Intl.Segmenter(undefined, {
    granularity: "grapheme"
  });

  return (...segmenter.segment(text))
    .slice(0, maxLength)
    .map(item => item.segment)
    .join("");
}
Agora sua função de contador e truncamento usa a mesma definição de caractere.
Essa consistência é mais importante do que parece.
Um contador que diz:
10 / 10
embora a lógica de truncamento danifique o emoji final, é uma experiência de produto confusa.
Um conjunto de testes Unicode compacto para manipulação de texto front-end
Você não precisa de centenas de fixtures para detectar os erros mais comuns do Unicode.
Um pequeno conjunto é suficiente para expor muitos problemas:
const cases = (
"Hello",
"café",
"e\u0301",
"😀",
"👍🏽",
"🇺🇸",
"👨👩👧👦",
"नमस्ते"
);
Execute-os por meio de qualquer recurso que:
- conta caracteres
- impõe um comprimento máximo
- trunca strings
- transforma ou normaliza texto
- copia texto para a área de transferência
- gera nomes de usuário ou nomes de exibição
- renderiza visualizações ao vivo
- envia texto para uma API ou validador de back-end
Um pequeno conjunto de testes como esse detecta muito mais problemas específicos do Unicode do que testes repetidos com sentenças comuns em inglês.
Erros comuns de JavaScript Unicode a serem evitados
Usando split("") para iteração de caracteres.
Ele divide unidades de código UTF-16 e pode quebrar caracteres suplementares.
Supondo (...text) resolve todos os problemas Unicode.
Ele lida com pontos de código, não com clusters completos de grafemas.
Usando string.length como uma contagem voltada para o usuário sem definir “caractere”.
A API está correta; a suposição do produto pode não ser.
Normalizando tudo com NFKC.
A normalização de compatibilidade pode alterar intencionalmente as distinções no texto original.
Testando apenas ASCII ou inglês.
Os bugs Unicode geralmente permanecem invisíveis até que emojis, acentos ou scripts não latinos apareçam.
Contando e truncando com unidades diferentes.
Use a mesma regra de segmentação para ambos.
Tratar a igualdade visual como igualdade de strings.
Duas strings podem ser renderizadas da mesma forma, embora contenham sequências Unicode diferentes.
Perguntas frequentes
É JavaScript string.length errado?
Não.
Ele retorna corretamente o número de unidades de código UTF-16 em uma string JavaScript.
Torna-se enganoso apenas quando um produto interpreta esse número como caracteres visíveis.
Como faço para contar Emoji como um caractere em JavaScript?
Para caracteres percebidos pelo usuário, use Intl.Segmenter com:
granularity: "grapheme"
Ele lida com muitas sequências de emojis, sinalizadores, marcas de combinação e outros grupos de grafemas com mais precisão do que string.length ou contagem de pontos de código.
É (...text).length Seguro para Unicode?
É mais seguro do que split("") porque conta pontos de código Unicode em vez de unidades de código UTF-16.
Ainda não garante um elemento por cluster de grafema visível.
Devo usar Intl.Segmenter para cada limite de texto?
Não automaticamente.
Use-o quando o limite do produto for baseado em caracteres percebidos pelo usuário.
Os limites de armazenamento, protocolo, API, bytes ou banco de dados podem exigir uma medição diferente.
Devo normalizar o texto antes de contá-lo?
Não por padrão.
Normalização e segmentação resolvem problemas diferentes.
Normalize somente quando seu aplicativo tiver um motivo claro para tratar sequências Unicode equivalentes de forma consistente.
Por que o mesmo texto Unicode pode parecer diferente em navegadores ou dispositivos?
Unicode define caracteres, mas a renderização de glifos depende de fontes, sistemas operacionais, navegadores e comportamento de fallback.
O texto subjacente pode permanecer idêntico enquanto sua aparência muda.
O verdadeiro bug geralmente é a suposição
A parte perigosa de um contador de caracteres JavaScript não é o loop ou o ouvinte de eventos.
É a suposição escondida dentro da palavra personagem.
Se o número for destinado a uma pessoa, os agrupamentos de grafemas geralmente são os que mais se aproximam do que ela vê e edita.
Se o número existir devido a um banco de dados, API, protocolo ou regra de armazenamento, conte o que o sistema realmente limita.
Antes de enviar sua próxima entrada de texto, teste:
- uma bandeira
- um emoji com modificador de tom de pele
- um sotaque combinado
- um emoji de família unida
- pelo menos uma escrita não latina
Se eles sobreviverem à contagem, truncamento, validação e copiar e colar intactos, seu contador de caracteres “simples” estará finalmente medindo o que você pretendia.
Biografia do autor
Mohsin é um estrategista de SEO e editor independente da web que cria e testa ferramentas da web baseadas em navegador, com interesse particular em texto Unicode, desempenho de front-end e como o conteúdo se comporta em navegadores e plataformas.
