


Este artigo é patrocinado por SerpAPI. As técnicas abaixo funcionam com qualquer provedor de pesquisa; SerpApi é usado para exemplos executáveis.
Se você perguntar a um grande modelo de linguagem o que aconteceu esta manhã, ele dirá que não sabe ou inventará algo plausível. Esse não é um bug do qual você possa sair. O problema é que o conhecimento de um modelo fica congelado no ponto de corte do treinamento, sem nenhuma conexão integrada com a web ativa. Se você estiver construindo algo que precise de dados atuais, como um assistente de pesquisa, um bot de suporte ou um agente de monitoramento de mercado, você mesmo terá que trazer a web para o modelo.
A técnica é mais simples do que parece. O problema é que buscar os dados é apenas metade do trabalho. A outra metade é incluí-lo no modelo de forma barata, porque os resultados brutos da pesquisa passam pela sua janela de contexto e pelo seu orçamento. Este guia cobre ambas as metades junto com o código.
Onde o conhecimento do modelo se esgota
Duas limitações estão em jogo e vale a pena separá-las porque as pessoas as confundem constantemente.
O primeiro é o limite de conhecimento. Os dados de treinamento são coletados até um determinado momento e, em seguida, incorporados aos pesos do modelo. Qualquer coisa depois dessa data, seja o lançamento de um produto, uma mudança de preço ou o resultado da partida de ontem, simplesmente não está lá.
A segunda é a falta de um índice ao vivo. Mesmo dentro de sua janela de treinamento, um modelo não “pesquisa”. Ele gera uma continuação estatisticamente provável do seu prompt com base nos padrões que aprendeu, sem nenhuma consulta ao banco de dados subjacente. Quando um modelo parece conhecer um fato, ele está relembrando uma impressão compactada dele, e não recuperando um registro. É exatamente por isso que os modelos alucinam detalhes como datas, números e citações.
Os preços são onde isso fica óbvio. Pergunte a um modelo algo como “Qual é o voo mais barato de Londres para Lisboa na próxima sexta-feira e quais são as tarifas de hotéis perto do centro nesse fim de semana?” e a resposta chegará em uma das três formas.
- Ele recusa. “Não tenho acesso a preços de voos ou hotéis em tempo real. Recomendo verificar o Skyscanner ou o Booking.com.” Honesto e inútil para seus usuários.
- Ele protege. “Os voos variam normalmente entre £40 e £120, e os hotéis de gama média no centro de Lisboa custam normalmente entre 90€ e 150€ por noite.” Amplo o suficiente para ser seguro, específico o suficiente para parecer útil e não uma resposta à pergunta feita.
- Ele compromete. “TAP Air Portugal, £ 58 com partida de Gatwick 07:15”com um hotel nomeado e tarifa por noite correspondentes. Parece exatamente um resultado real, mas é uma reconstrução das tarifas absorvidas durante o treinamento, e nada disso pode sobreviver ao contato com um site de reservas.
A terceira forma é a perigosa: nada na saída sinaliza que o número está obsoleto, então o usuário não consegue distinguir uma tarifa real de uma lembrada. O mesmo vale para preços de produtos, níveis de estoque e qualquer outra coisa que se mova.
A recuperação resolve ambos os problemas da mesma maneira: busque os fatos atuais e entregue-os ao modelo como contexto, depois peça-lhe que raciocine sobre o que você forneceu. O modelo deixa de ser a fonte da verdade e passa a ser aquilo que a lê. Este é o princípio por trás da geração aumentada por recuperação (RAG); a pesquisa na web é apenas RAG, onde a base de conhecimento é toda a internet.
Suporte moderno a APIs LLM chamada de ferramenta (também chamado de chamada de função), o que facilita a construção do fluxo de recuperação de busca e motivo. Você descreve um search ferramenta ao modelo. Quando uma pergunta requer informações novas, o modelo não responde diretamente; em vez disso, ele emite uma solicitação para chamar sua ferramenta com uma string de consulta. Seu código executa a pesquisa, retorna os resultados e o modelo escreve sua resposta com base no que você retornou.
Aqui está o ciclo:
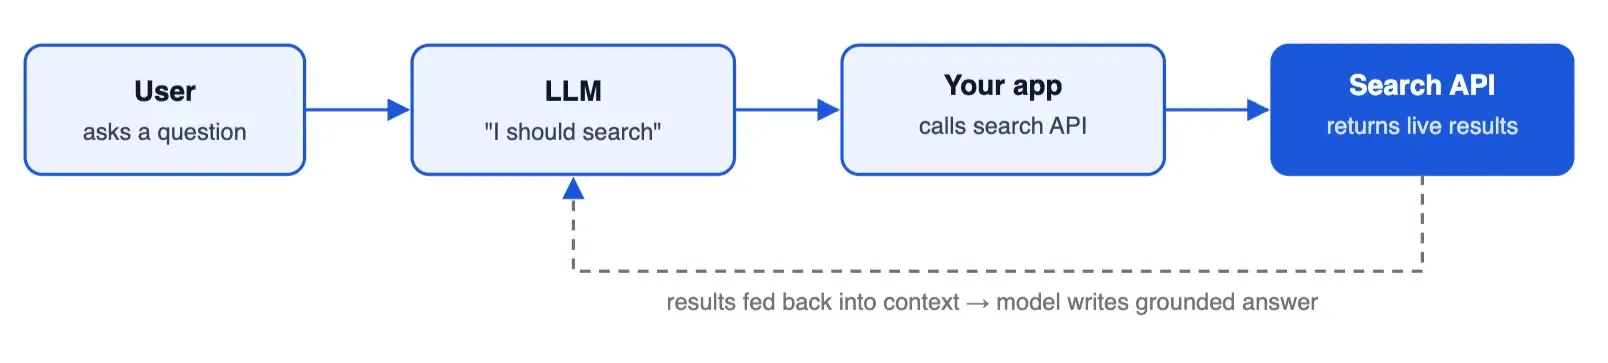
Ao implementar isso, você concede uma capacidade e deixa o modelo decidir quando pesquisar e o que procurar.
Construindo: um passo a passo prático
Vamos configurar uma versão básica em Python. Usaremos uma API de conclusão de bate-papo no estilo OpenAI para o modelo, porque essa forma de chamada de ferramenta é a mais amplamente reconhecida (troque por qualquer modelo ao qual você tenha acesso). Porém, o padrão é independente do provedor: o mesmo loop funciona com Gemini do Google, Claude da Anthropic ou um modelo local; apenas as chamadas do SDK são diferentes. Para a etapa de pesquisa, usaremos SerpApi como nossa API de pesquisa na web. Você precisará correr pip install openai requests e defina as chaves de API como variáveis de ambiente.
Etapa 1: escreva a função de pesquisa
Este é um código simples, sem IA envolvida ainda. É necessária uma consulta e retorna resultados do SERP ao vivo.
import os
import requests

def web_search(query: str) -> str:
    """Run a live Google search and return the results as text."""
    resp = requests.get(
        "https://serpapi.com/search",
        params={
            "engine": "google",
            "q": query,
            "api_key": os.environ("SERPAPI_API_KEY")
        },
        timeout=20,
    )
    resp.raise_for_status()
    data = resp.json()

    lines = ()
    for r in data.get("organic_results", ())(:5):
        title = r.get("title", "")
        snippet = r.get("snippet", "")
        link = r.get("link", "")
        lines.append(f"- {title}\n  {snippet}\n  {link}")
    return "\n".join(lines) or "No results found."
Etapa 2: Descreva a ferramenta para o modelo
O modelo precisa de um esquema para saber que a ferramenta existe e quais argumentos ela utiliza.
tools = (
    {
        "type": "function",
        "name": "web_search",
        "description": (
            "Search the live web for current information. "
            "Use this whenever the answer depends on recent or real-time data."
        ),
        "parameters": {
            "type": "object",
            "properties": {
                "query": {
                    "type": "string",
                    "description": "The search query to run.",
                }
            },
            "required": ("query"),
        },
    }
)
Etapa 3: execute o loop
Envie a pergunta, deixe o modelo decidir se deve chamar a ferramenta, executar a pesquisa se ela perguntar, retornar o resultado e obter a resposta fundamentada.
import json

from openai import OpenAI

client = OpenAI()

def ask(question: str) -> str:
    messages = ({"role": "user", "content": question})


    first = client.responses.create(
        model="gpt-5.6-luna",
        input=messages,
        tools=tools,
    )
    messages.extend(first.output)


    for call in first.output:
        if call.type == "function_call":
            args = json.loads(call.arguments)
            results = web_search(args("query"))
            messages.append(
                {
                    "type": "function_call_output",
                    "call_id": call.call_id,
                    "output": results,
                }
            )

    if any(call.type == "function_call" for call in first.output):

        second = client.responses.create(
            model="gpt-5.6-luna",
            input=messages,
            tools=tools,
            tool_choice="none",
        )
        return second.output_text


    return first.output_text


print(ask("What are the newest features announced for the Python 3.14 release?"))
O modelo pede uma pesquisa, seu código a executa e o modelo responde. Configurações mais avançadas apenas repetem ou estendem essas três etapas: pesquisar várias vezes antes de responder, adicionar mais ferramentas, pedir ao modelo para citar suas fontes ou transmitir a resposta conforme está escrita.
Use o mecanismo certo para a pergunta
O web_search A função acima pesquisa na web geral, que cobre a maioria das questões. Algumas perguntas têm uma fonte melhor. Por exemplo, a questão de preços com a qual abrimos: você pode consultar o Google Flights diretamente e obter os resultados como dados estruturados. A única coisa que muda é o engine parâmetro:
def flight_search(origin: str, destination: str, depart: str, ret: str) -> str:
    resp = requests.get(
        "https://serpapi.com/search",
        params={
            "engine": "google_flights",
            "departure_id": origin,
            "arrival_id": destination,
            "outbound_date": depart,
            "return_date": ret,
            "api_key": os.environ("SERPAPI_API_KEY"),
        },
        timeout=20,
    )
    resp.raise_for_status()
    data = resp.json()

    lines = ()
    for option in data.get("best_flights", ())(:3):
        leg = option("flights")(0)
        lines.append(
            f"- {leg('airline')} {leg('flight_number')}: "
            f"{leg('departure_airport')('id')} {leg('departure_airport')('time')} "
            f"to {leg('arrival_airport')('id')} {leg('arrival_airport')('time')}, "
            f"{option('price')} {data.get('search_parameters', {}).get('currency', 'USD')}"
        )

    insights = data.get("price_insights", {})
    if insights:
        low, high = insights.get("typical_price_range", (None, None))
        lines.append(f"Lowest found: {insights.get('lowest_price')}. Typical range: {low} to {high}.")

    return "\n".join(lines) or "No flights found."
Registre-o como uma segunda ferramenta ao lado web_search e o modelo escolhe o que se adapta à questão. Agora a resposta traz números reais de voos, horários reais de partida e uma price_insights banda dizendo se a tarifa é realmente boa, nenhuma das quais o modelo poderia ter inventado.
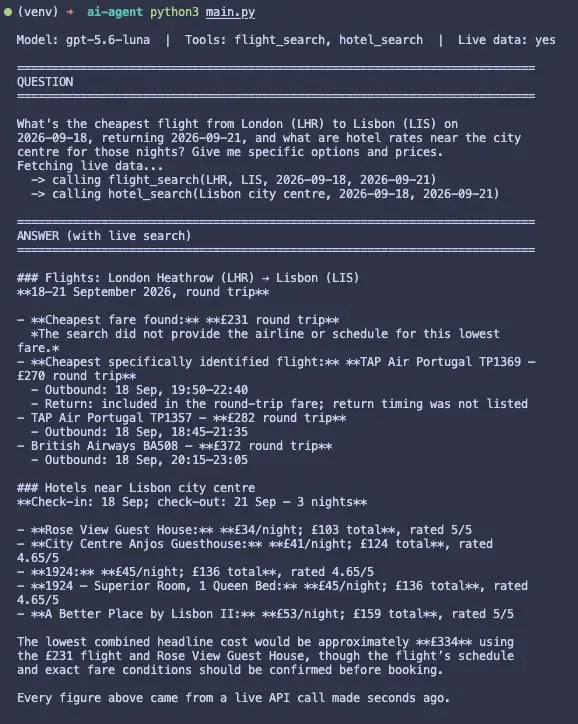
A mesma troca de um parâmetro funciona para todos os outros mecanismos. Alguns que são mais importantes para os agentes:
| Motor | Use-o para |
|---|---|
google_hotels |
Tarifas noturnas e totais, classificações, disponibilidade para determinadas datas |
google_shopping |
Listagens de produtos, preços atuais, vendedores, estoque |
google_news |
Cobertura recente de um tópico, com datas de publicação |
google_maps |
Empresas locais, horários, endereços, comentários |
google_trends |
O interesse ao longo do tempo, por “isso está aumentando?” questões |
youtube |
Resultados de vídeo e dados do canal |
walmart, ebay, amazon |
Preços de varejo fora do Google |
A lista completa é executada mais de 100 pontos de extremidadeincluindo os resultados do Yelp, Tripadvisor, Zillow e AI Overview, e mecanismos que não são do Google (Bing, DuckDuckGo, Yahoo, Baidu, Yandex, Naver) seguem o mesmo padrão.
O custo oculto de alimentar um modelo com resultados de pesquisa
Execute o código acima algumas vezes e funciona. Envie-o e você notará duas coisas aumentando: sua latência e sua fatura. Aqui está o porquê.
As respostas da API de pesquisa são detalhado. Uma carga útil JSON SERP bruta está cheia de coisas que seu modelo não precisa: parâmetros de rastreamento, posições de pixel, favicons base64, campos de URL duplicados, tokens de paginação, metadados de exibição. Coloque isso no contexto e cada personagem se tornará um token pelo qual você paga no lado da entrada de cada turno subsequente, porque o contexto se acumula.
A situação piora de três maneiras agravadas:
- Custo. Você paga por token de entrada. Um blob JSON gordo para cinco resultados, várias vezes por conversa, aumenta rapidamente em escala.
- Latência. Entradas maiores demoram mais para serem processadas, retardando cada resposta.
- Precisão. Aquele que as pessoas sentem falta. Os modelos sofrem de um efeito “perdido no meio”, onde os fatos enterrados em um contexto grande e barulhento são negligenciados com mais frequência do que os mesmos fatos em um contexto restrito. Preencher a janela não custa apenas dinheiro; pode piorar as respostas.
Alimente o modelo Markdown
Uma abordagem mais limpa é pedir ao seu provedor Remarcação em vez de JSON em primeiro lugar. É o formato no qual os LLMs são mais fluentes e elimina o lixo orientado à máquina, mantendo a estrutura que importa: títulos, listas, tabelas e links.
SerpApi adicionou um Saída de redução modo exatamente para isso. Você solicita adicionando output=md para a mesma chamada:
def web_search_md(query: str) -> str:
    """Return live search results as clean, LLM-ready Markdown."""
    resp = requests.get(
        "https://serpapi.com/search",
        params={
            "engine": "google",
            "q": query,
            "api_key": os.environ("SERPAPI_API_KEY"),
            "output": "md",
        },
        timeout=20,
    )
    resp.raise_for_status()
    return resp.text
Duas coisas a serem observadas:
- O loop de análise desapareceu: o corpo da resposta vai direto para o modelo porque já está legível.
- De acordo com números do próprio SerpApi, Markdown é executado em média cerca de 50% menor que o JSON equivalenteaumentando para 90% nos tipos de resultados pesados, que são exatamente as cargas de voo, hotel e compras anteriores. Mesmos fatos, uma fração dos tokens, nenhum código de extração para manter.
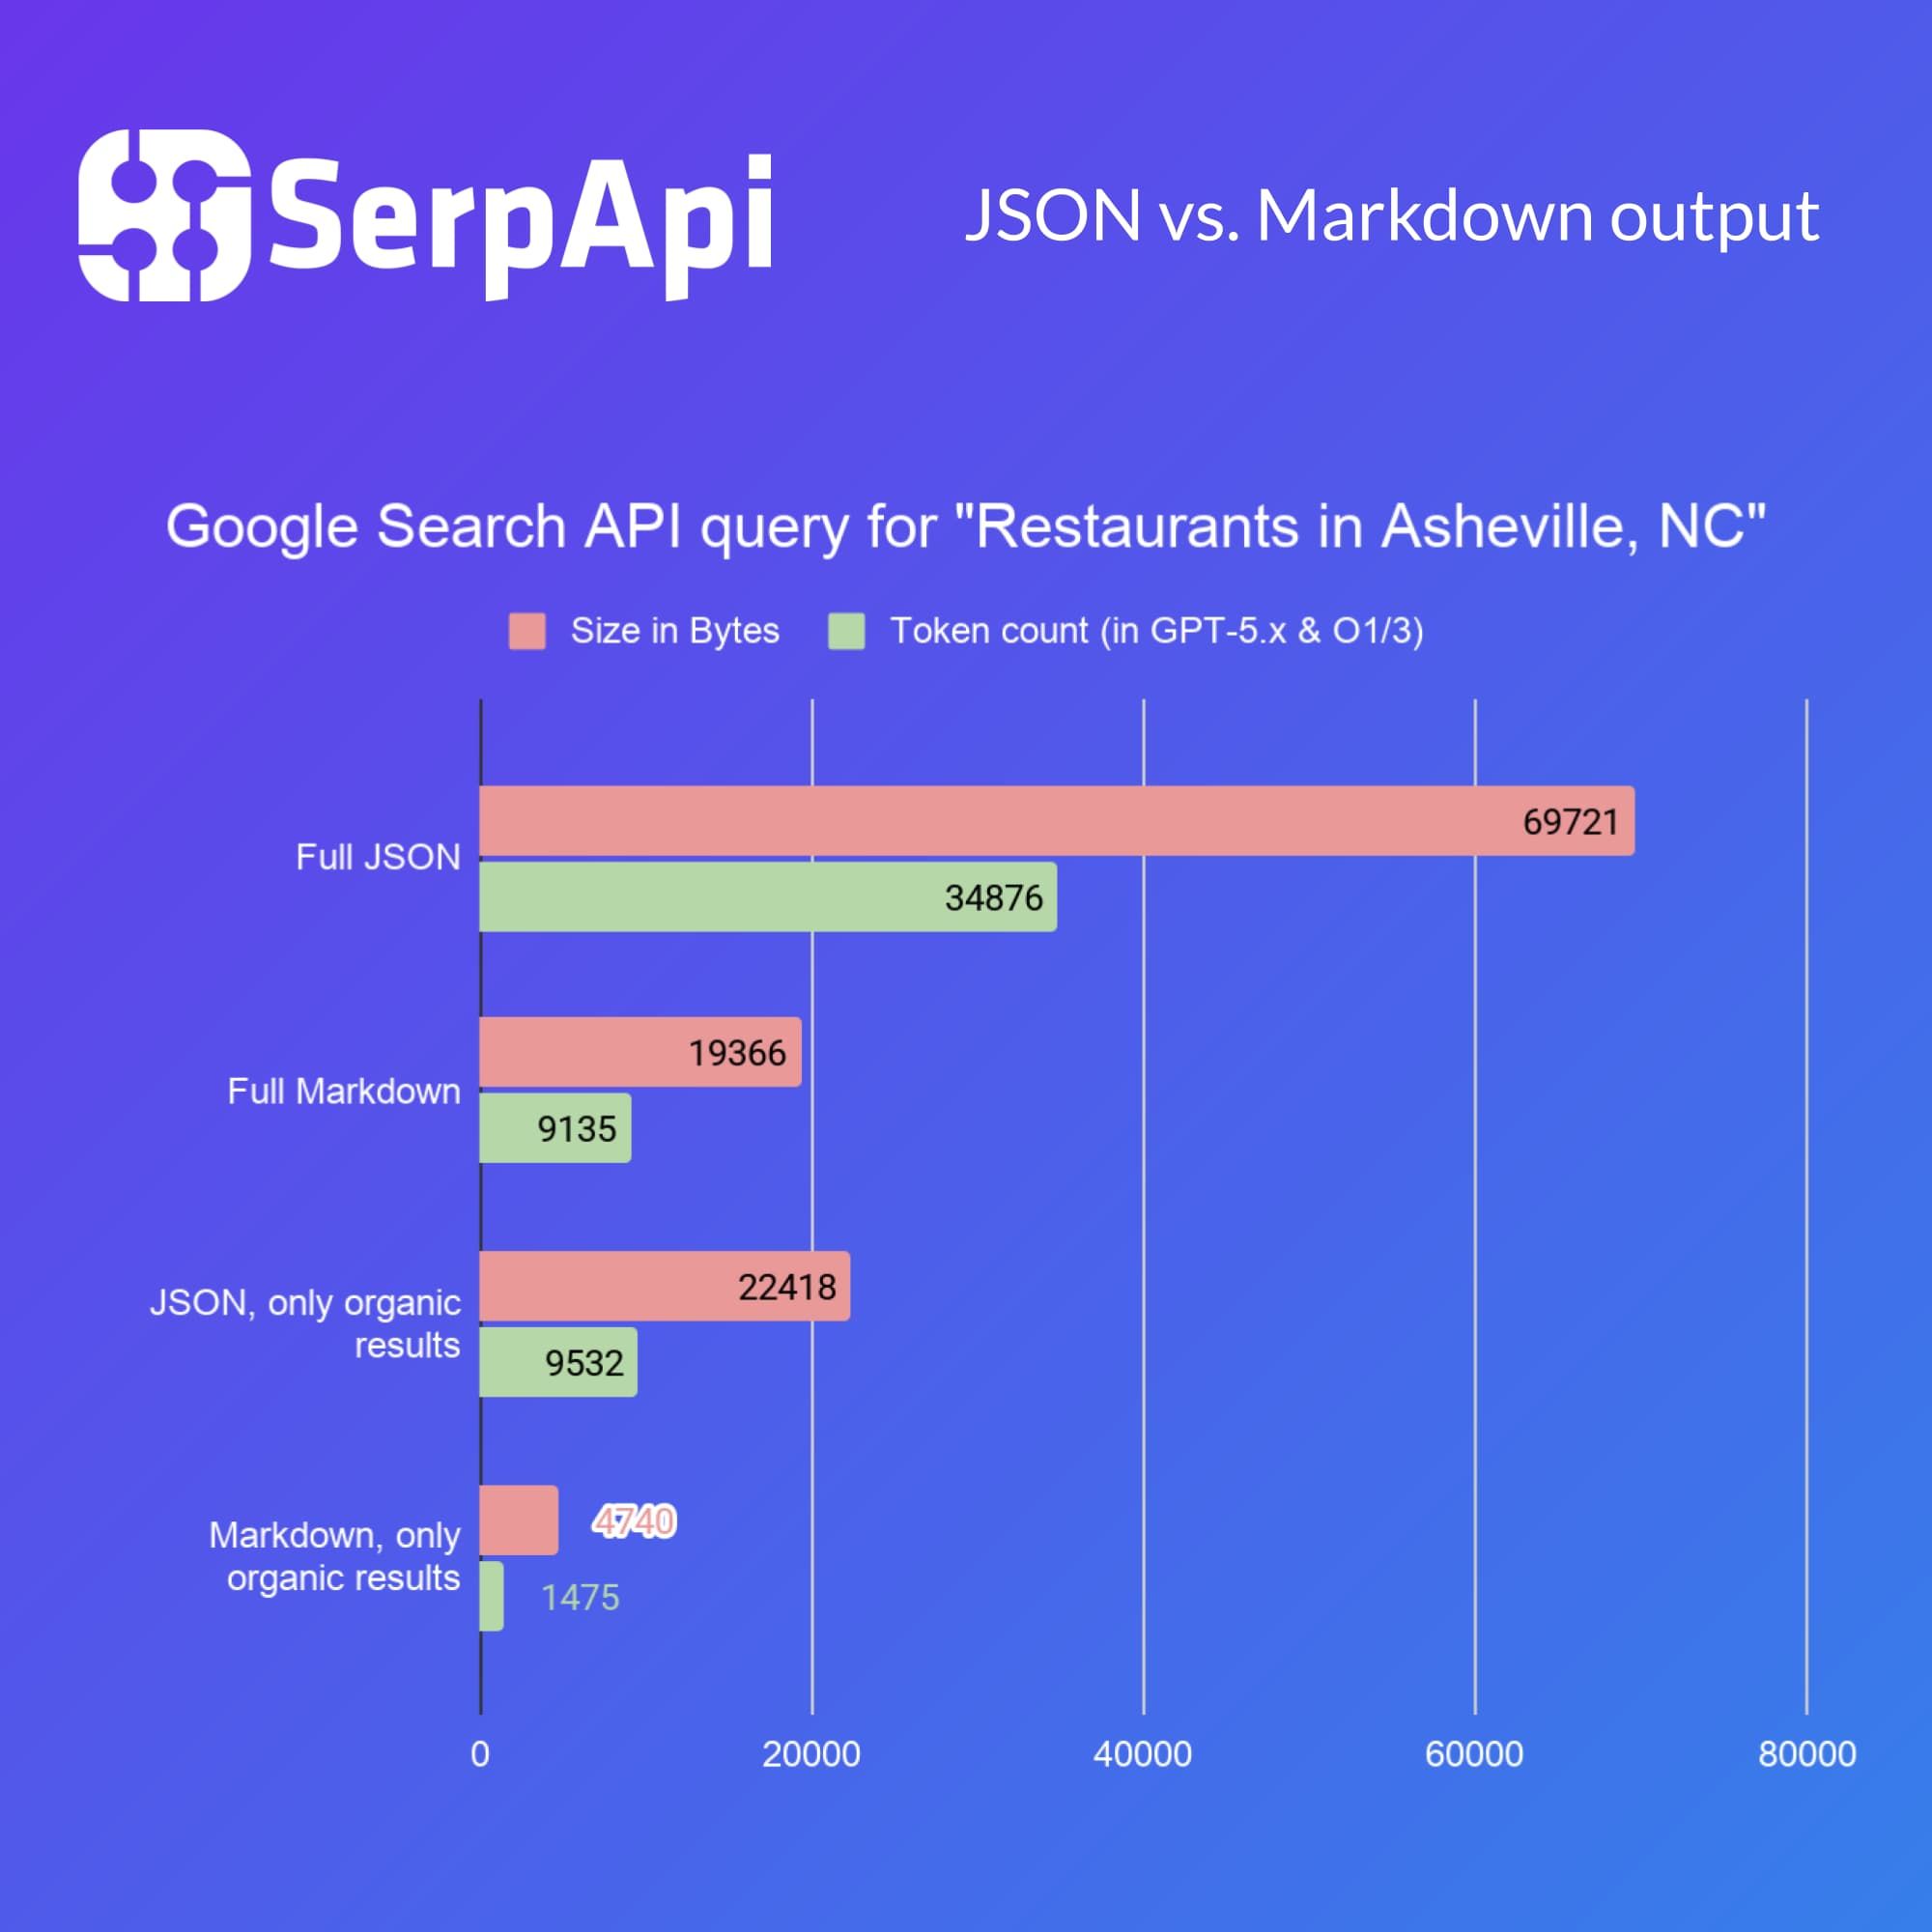
Você também não precisa escolher globalmente: solicite JSON onde seu código precisa de campos estruturados e Markdown onde o destino é a janela de contexto de um modelo. É uma decisão por chamada.
Preparando-o para produção
O loop mais Markdown proporciona um núcleo sólido. Alguns refinamentos separam uma demonstração de algo que você apresentaria aos usuários.
Armazene em cache seletivamente. Consultas idênticas repetidas devem atingir o cache em vez da API, mas definir o tempo de vida para corresponder à rapidez com que os dados mudam. O material de referência e a pesquisa de base podem permanecer no cache por horas. Tarifas de voo, disponibilidade de hotéis, preços de compras e notícias de última hora podem mudar em minutos, então dê a eles uma vida útil curta ou ignore totalmente o cache. Um preço obsoleto é pior do que um preço lento.
Lide com falhas com elegância. Encerre a chamada de pesquisa e, quando atingir o tempo limite ou os limites de taxa, retorne uma breve nota que o modelo pode retransmitir em vez de interromper a conversa.
Controle o que você alimenta. Mais resultados não são melhores. Três a cinco bons geralmente vencem dez, em precisão e em fichas. Corte antes de enviar.
Decida a atualização por consulta. Nem toda pergunta precisa de dados ao vivo. Uma descrição de ferramenta bem escrita estimula o modelo a pesquisar apenas quando o tempo recente realmente importa.
Onde levar a seguir
Depois que o loop funciona, a mesma base é dimensionada. Nada limita o tools list a uma função: adicione uma segunda e uma terceira, e o modelo escolhe qual chamar e em que ordem. Uma ferramenta de pesquisa encontra um artigo promissor e, em seguida, uma ferramenta de raspagem extrai seu texto completo; uma ferramenta de banco de dados consulta seus próprios registros quando a pergunta é sobre seus dados. Você escreveu web_search e flight_search acima, e o modelo já escolheu entre eles. Esse é todo o mecanismo e continua funcionando conforme você adiciona mais. Você também pode expor sua ferramenta de pesquisa no Protocolo de Contexto do Modelo (MCP) para que estruturas de agentes e assistentes de desktop possam usá-lo sem cola personalizada. E você pode agrupar os resultados da web em um pipeline RAG mais amplo que combina pesquisa ao vivo com seus próprios documentos indexados.
A maioria das estruturas de agentes já possui um caminho de pesquisa em tempo real, portanto, raramente você começa do zero. Se você preferir não rolar manualmente as definições de ferramentas, ferramentas de pesquisa serpapi embala-os para você: pip install serpapi-search-toolsentão solte web_search(), news_search(), flights_search()ou hotels_search() direto para o seu agente. Ele detecta seu SDK instalado automaticamente e oferece suporte ao OpenAI Agents SDK, Pydantic AI, LangChain, CrewAI, LlamaIndex, Claude Agent SDK e Google ADK, ou é executado como funções Python simples, sem nenhuma estrutura.
Qualquer que seja o caminho que você tome, os princípios aqui são válidos: deixe o modelo decidir quando pesquisar, mantenha um controle rígido sobre o que retorna e observe o formato dos dados que você entrega a ele.
Concluindo
Fornecer uma pesquisa na web em tempo real do LLM se resume a um loop modesto: deixe o modelo solicitar uma pesquisa, execute-a em seu código e retorne os resultados para obter uma resposta fundamentada. O que é fácil ignorar é quanto custam esses resultados quando contextualizados, e é por isso que o formato é tão importante quanto os dados. Analise implacavelmente ou solicite Markdown e pule a análise enquanto reduz aproximadamente pela metade a carga do token.
Construa o loop, observe sua janela de contexto e seu modelo parará de adivinhar o presente e começará a lê-lo.
Pronto para experimentar? Pegue uma chave gratuita (250 pesquisas por mês, sem cartão de crédito) e execute os exemplos acima em SerpAPI.
Perguntas frequentes
Quais LLMs podem pesquisar na web? Nenhum nativamente; um modelo sozinho não tem índice ativo. Você pode pesquisar qualquer modelo por meio de um loop de chamada de ferramenta como o mostrado acima. Os recursos de “navegação” em alguns produtos de chat são apenas esse padrão configurado para você.
Posso fornecer acesso local à Internet para um LLM? Sim. A arquitetura é idêntica para modelos locais via Ollama ou LM Studio: seu código executa a pesquisa e retorna os resultados. O modelo nunca toca a rede; seu aplicativo faz.
Preciso de um banco de dados vetorial? Não para pesquisa básica na web. Os armazenamentos de vetores são importantes na recuperação de um grande corpus privado. Para resultados ao vivo inseridos diretamente no contexto, pule essa camada.
Source link
