


Cada registro de prompt que testamos pode alterar um prompt em um aplicativo TypeScript em execução, revertê-lo e fornecer diferentes versões de produção e teste. O prompt hub da LangSmith, Langfuse, Phoenix e AcruxCore passaram nesses três testes. As diferenças reais aparecem em outros lugares: qual sintaxe de modelo cada um aceita, quantos pacotes npm ele extrai, quanto tempo uma alteração leva para chegar ao aplicativo e o que acontece quando o registro está inativo.
Testamos tudo isso com um pequeno aplicativo e um prompt, que possui uma condição e um loop. Os arquivos Git serviram como base. Cada número abaixo vem de uma corrida gravada.
Os resultados em resumo
| Arquivos Git | Lang Smith | Langfus | Fênix | AcruxCore | |
|---|---|---|---|---|---|
| Alterar um prompt sem implantar | Não (confirmar e implantar) | Sim | Sim | Sim | Sim |
| Reverter | git revert e implantar |
Mover uma etiqueta | Mover um rótulo | Mover uma etiqueta | Mover um alias |
| Produção e encenação em diferentes versões | Ramos ou arquivos separados | Sim | Sim | Sim | Sim |
| Lógica dentro do modelo | Jinja2 (freiras) | Seções de bigode | Seções de bigode | Nenhum | Jinja2 (freiras) |
| Tempo até que um aplicativo em execução veja uma alteração (padrão) | Próxima implantação | 300 segundos | 62 segundos | 0 segundos | 62 segundos |
| pacotes npm instalados | 4 | 23 | 5 | 57 | 3 |
Tamanho de node_modules |
2MB | 70MB | 8 MB | 90MB | 12 MB |
| Linhas para buscar e renderizar | 7 | 8 | 6 | 16 | 6 |
A versão curta:
- Escolha Git if os prompts mudam apenas com a frequência do seu código.
- Escolha um registro quando as pessoas que não implantam código precisam alterar os prompts ou quando você precisa de uma reversão que não espera pela implantação.
- Entre os registros, as questões decisivas são a lógica do modelo e as dependências.
Cinco lugares onde um prompt pode residir
A maioria das equipes começa com prompts no código: uma sequência de modelo ou um .txt arquivo próximo ao código que o utiliza. Isso funciona até que um gerente de produto queira alterar uma frase, e a mudança tenha que esperar por um lançamento completo.
Um registro de prompt move o texto para fora da implantação. O aplicativo busca o prompt por nome e por um rótulo como production. Você altera a versão para a qual o rótulo aponta e o aplicativo seleciona o novo texto sem implantar.
O prompt hub da LangSmith é o registro mais conhecido, mas não é o único. Vários dos LangSmith alternativas também gerencia prompts, e três deles são de código aberto e auto-hospedáveis: Langfuse, Phoenix e AcruxCore. Abordamos como essas ferramentas lidam com o rastreamento em Alternativas auto-hospedadas do LangSmith: 4 ferramentas testadas em um agente TypeScript. Este artigo cobre apenas prompts.
Como testamos
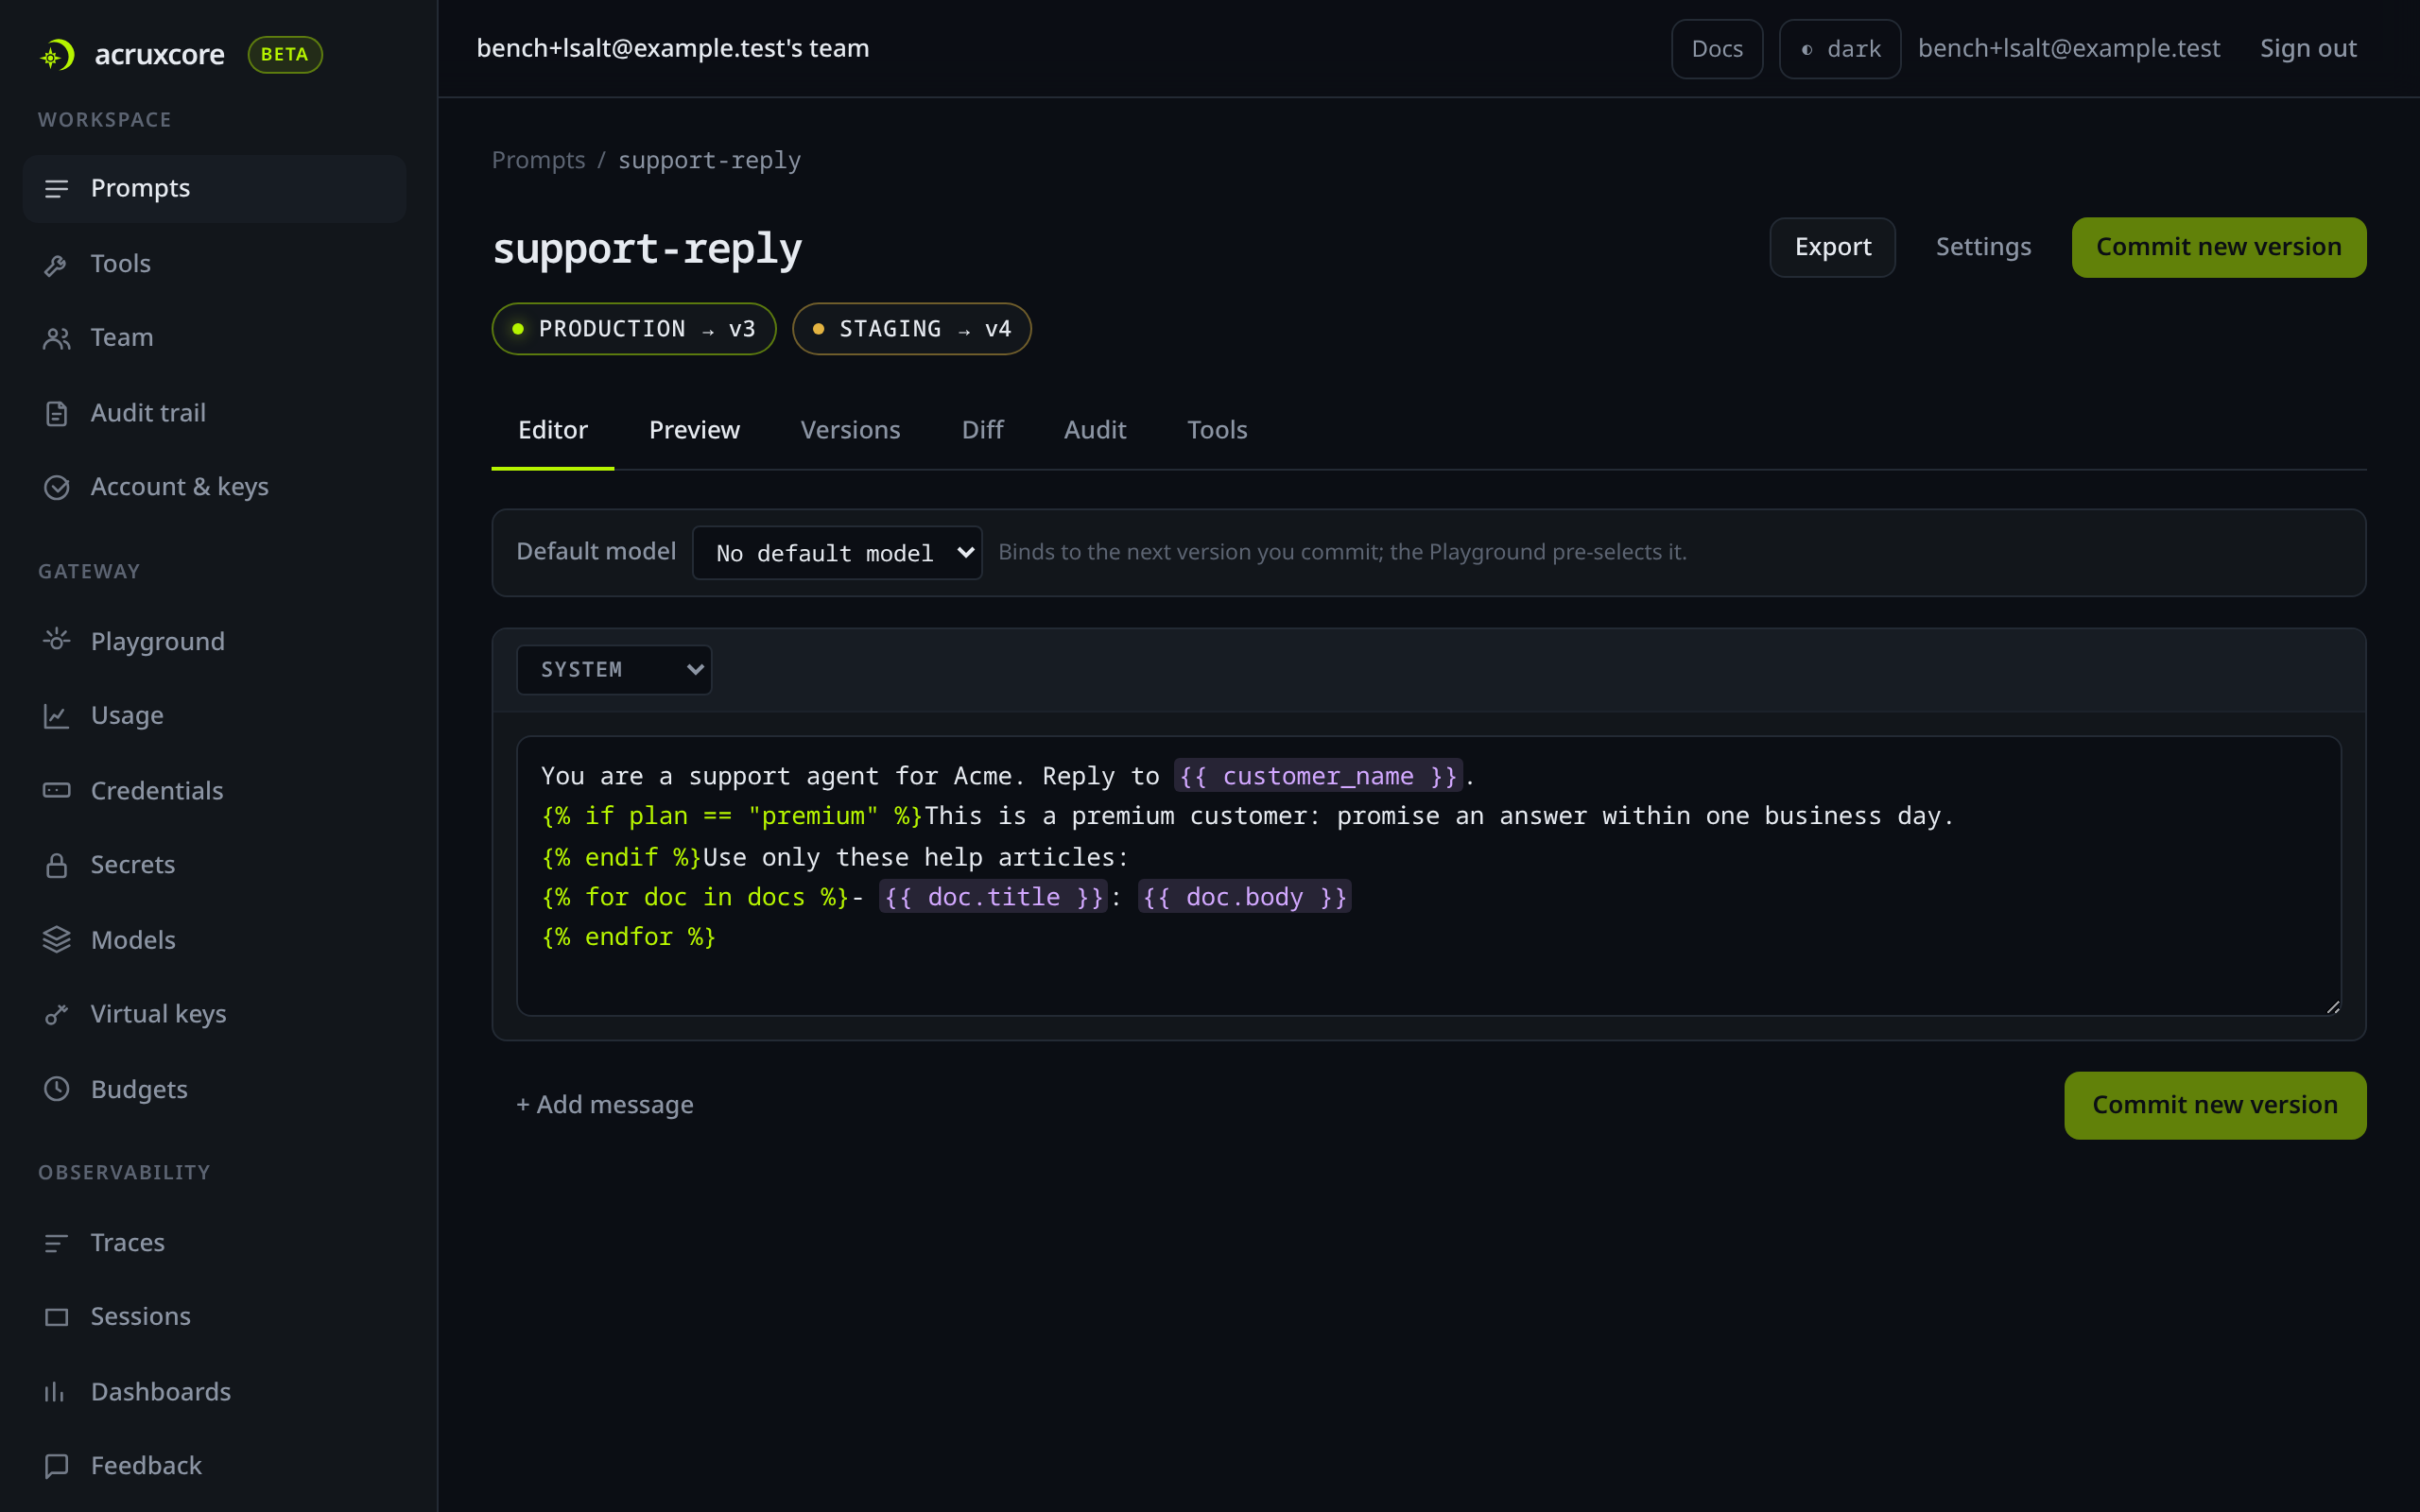
Cada ferramenta recebeu o mesmo prompt, support-reply. Seu modelo utiliza três variáveis: um nome do cliente, um plano e uma lista de artigos de ajuda. Tem uma condição: a linha prioritária aparece apenas para clientes premium. Ele também possui um loop: uma linha por artigo de ajuda. Na sintaxe Jinja2, o modelo se parece com isto:
You are a support agent for Acme. Reply to {{ customer_name }}.
{% if plan == "premium" %}This is a premium customer: promise an answer within one business day.
{% endif %}Use only these help articles:
{% for doc in docs %}- {{ doc.title }}: {{ doc.body }}
{% endfor %}
Um artigo de ajuda contém o texto Settings > Export. Nós o incluímos de propósito, para capturar qualquer ferramenta que escape do HTML > em >.
Cada ferramenta executou a mesma sequência de um script TypeScript:
- Publique a versão 1 e aponte ambas
productionestagingnisso. - Publique a versão 2, que altera uma frase. Verifique isso
productionainda retorna a versão 1. - Mover
productionpara a versão 2 e verifique se o mesmo processo em execução agora recebe o novo texto. - Mover
productionde volta à versão 1, que é a reversão. - Apontar
stagingna versão 2 e verifique se ambos os rótulos retornam sua própria versão ao mesmo tempo. - Renderize para um cliente premium com dois artigos e para um cliente gratuito sem nenhum. Compare ambos com o texto esperado.
Cada ferramenta usou seu próprio SDK TypeScript documentado. Os quatro registros passaram em todas as seis etapas. O restante deste artigo aborda como cada um chegou lá e quanto custou.
Configurar:
- Nó 22.23.
- Nuvem LangSmith, região da UE.
- Auto-hospedado em Docker: Langfuse 4.5.0, Phoenix 19.18.0 e uma versão AcruxCore de 17 de setembro de 2026.
- SDKs:
langsmith0.11.8 comlangchain1.6.3,@langfuse/client6.1.1,@arizeai/phoenix-client7.18.2,@acruxcoreai/sdk0.20.0. - Data do teste: 8 de novembro de 2026.
Arquivos Git: a linha de base
Manter os prompts no repositório não custa quase nada. O modelo fica em prompts/support-reply.njke nunjucks, a porta JavaScript do Jinja2, renderiza:
import { readFileSync } from "node:fs";
import nunjucks from "nunjucks";

const template = readFileSync("prompts/support-reply.njk", "utf8");
const env = new nunjucks.Environment(null, { autoescape: false });

export async function systemPrompt(vars: Vars): Promise<string> {
  return env.renderString(template, vars);
}
O autoescape: false linha é importante. Nossa primeira versão chamada nunjucks.renderString() diretamente e o teste falhou. O ambiente padrão HTML escapa de sua saída, então Settings > Export chegou ao modelo como Settings > Export. O escape é correto para páginas da web e errado para prompts.
O Git oferece Jinja2 completo, revisão de código em cada alteração de prompt e histórico no mesmo local do código. O que não pode fazer é alterar um prompt em um aplicativo em execução. Cada edição e cada reversão aguardam uma implantação.
LangSmith: bigode através do LangChain
LangSmith armazena um prompt como um objeto LangChain serializado (ChatPromptTemplate), não como texto simples. A própria documentação do LangSmith diz que você deve usar o pacote LangChain npm para obter prompts no TypeScript (Gerenciar prompts programaticamente). Portanto, um aplicativo TypeScript simples que usa o openai pacote ainda precisa langchain e @langchain/core:
import { Client } from "langsmith";
import { pull } from "langchain/hub";
import type { ChatPromptTemplate } from "@langchain/core/prompts";

const client = new Client();

export async function systemPrompt(vars: Vars): Promise<string> {
  const prompt = await pull<ChatPromptTemplate>("support-reply:production", { client });
  const (message) = await prompt.formatMessages({ ...vars, is_premium: vars.plan === "premium" });
  return message.content as string;
}
Esses três pacotes instalaram 23 pacotes e 70 MB. A maior parte do tamanho é @langchain/* (27 MB) e js-tiktoken (22 MB).
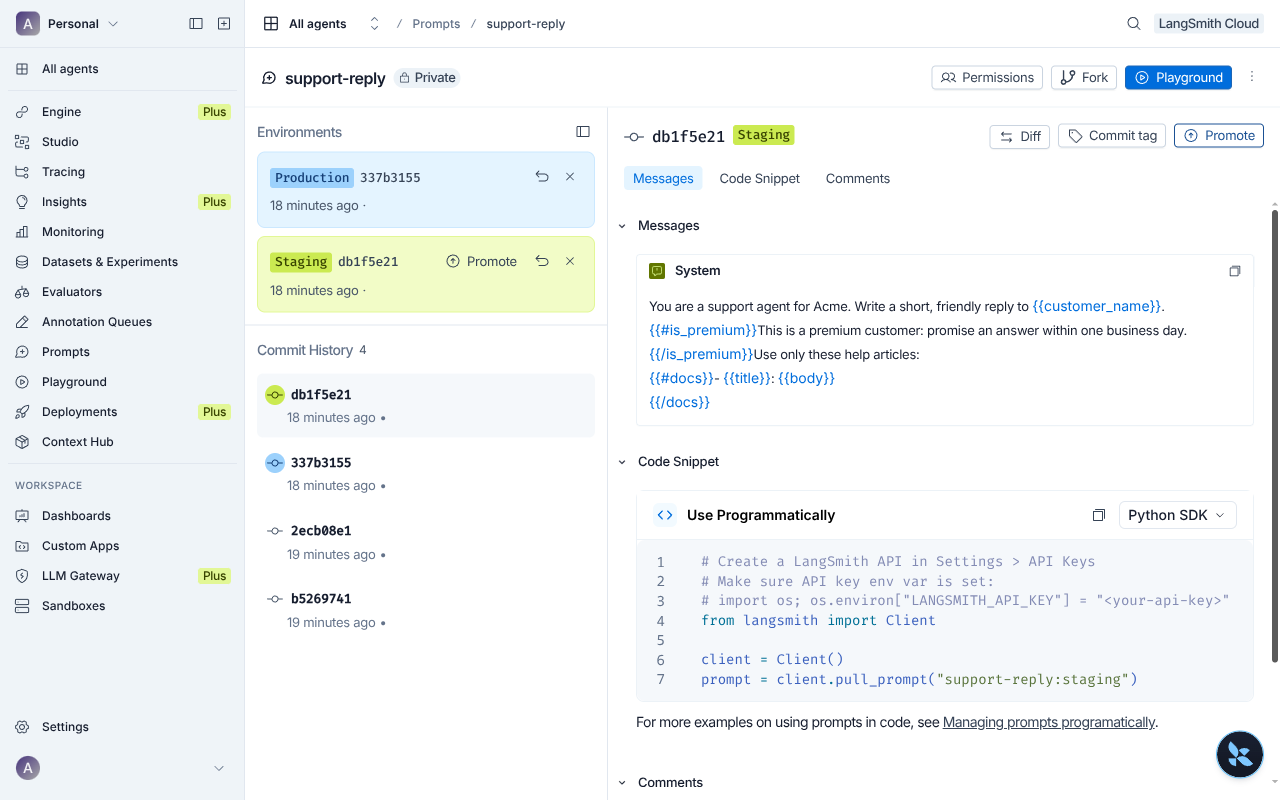
Modelos. No TypeScript, LangChain aceita modelos f-string e bigode. Seções de bigode ({{#docs}}…{{/docs}}) tratou do nosso loop. Bigode não tem ==porém, então o cheque prêmio se tornou um is_premium booleano calculado em código. Nós também tentamos templateFormat: "jinja2"que o pacote Python do LangChain suporta. No TypeScript ele jogou DEFAULT_PARSER_MAPPING(templateFormat) is not a function.
Rótulos e reversão. production e staging são tags reservadas e a documentação as move na UI. O langsmith O cliente JavaScript não possui nenhum método público que mova uma tag. Nosso script chamou a mesma rota REST que o SDK usa internamente (POST /api/v1/repos/-/). Funcionou, mas não é uma API documentada.
Cache. O SDK armazena em cache solicitações de 300 segundos por padrão. Em nosso teste, um aplicativo em execução viu a nova versão 300 segundos depois de movermos a tag.
Langfuse: cliente pequeno, bigode sob o capô
O cliente TypeScript da Langfuse é um pacote, @langfuse/client. Instalou 5 pacotes e 8 MB:
import { LangfuseClient } from "@langfuse/client";

const langfuse = new LangfuseClient();

export async function systemPrompt(vars: Vars): Promise<string> {
  const prompt = await langfuse.prompt.get("support-reply", { label: "production" });

  return prompt.compile({ ...vars, is_premium: vars.plan === "premium" } as never);
}
Criar uma versão, mover um rótulo e ler por rótulo são chamadas públicas do SDK: prompt.create, prompt.update e prompt.get (Comece com o gerenciamento imediato).
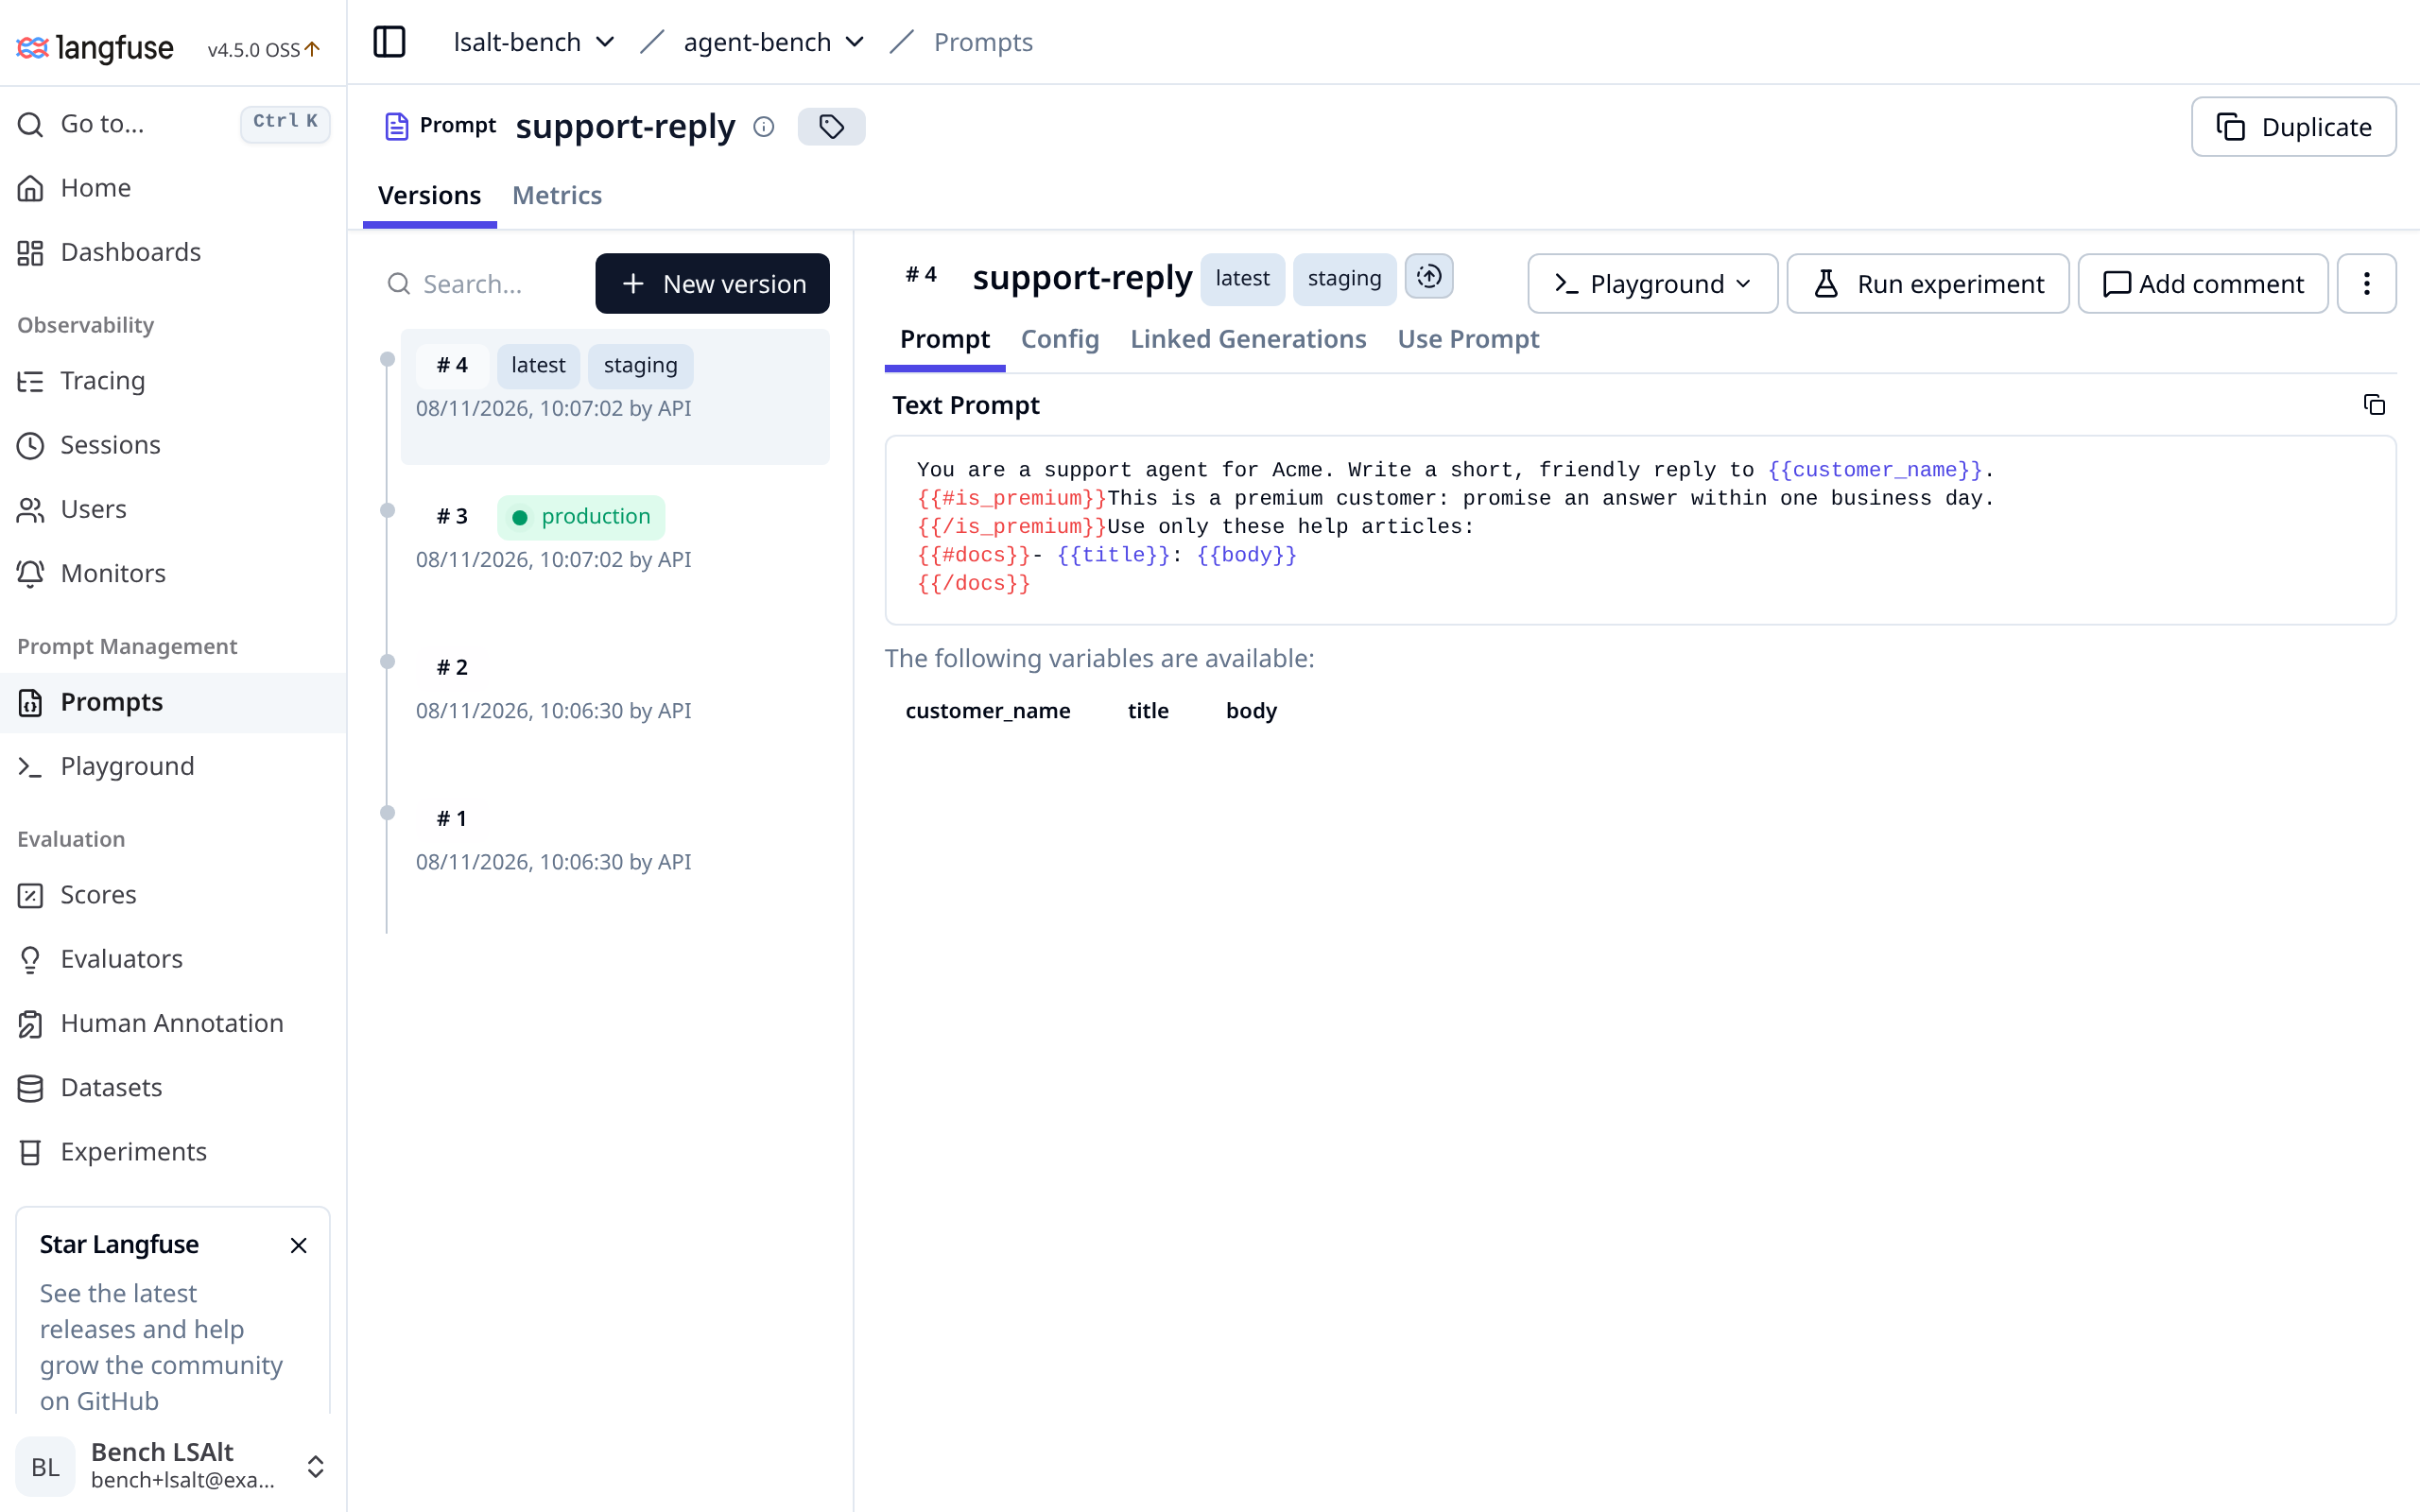
Modelos. A documentação mostra apenas {{variable}} substituição. Mas compile() chama o mustache biblioteca, então as seções funcionaram para nosso loop. A assinatura de tipo aceita apenas valores de string, portanto, passar uma lista precisava de uma conversão. A IU do Langfuse colore as tags da seção em vermelho e lista title e body como variáveis do prompt, não docs ou is_premium. Não dependeríamos de um comportamento que a documentação não promete. Quando enviamos a versão Jinja2, Langfuse retornou o {% if %} e {% for %} tags inalteradas, sem erros. O modelo os teria recebido como texto.
Cache. O tempo de cache é de 60 segundos por padrão (Cache). Nosso aplicativo percebeu a mudança após 62 segundos. Langfuse também é o único cliente com um fallback opção: uma string de prompt que o SDK usa quando não consegue acessar o servidor em uma inicialização a frio.
Phoenix: sem lógica de modelo, sem cache
O cliente TypeScript do Phoenix busca um prompt por nome e tag, e toSDK() converte-o para o formato de mensagem que openai pacote espera. Os modelos Phoenix apenas substituem variáveis, portanto a condição e o loop devem ser executados em seu código antes da renderização:
import { createClient } from "@arizeai/phoenix-client";
import { getPrompt, toSDK } from "@arizeai/phoenix-client/prompts";

const client = createClient();

export async function systemPrompt(vars: Vars): Promise<string> {
  const prompt = await getPrompt({ client, prompt: { name: "support-reply", tag: "production" } });
  if (!prompt) throw new Error("prompt not found or Phoenix unreachable");
  const { messages } = toSDK({
    sdk: "openai", prompt,
    variables: {
      customer_name: vars.customer_name,
      priority_line: vars.plan === "premium" ? "This is a premium customer: promise an answer within one business day." : "",
      docs_block: vars.docs.map((d) => `- ${d.title}: ${d.body}`).join("\n"),
    },
  })!;
  return messages(0).content as string;
}
São 16 linhas, contra 6 a 8 dos demais registros. Todas as linhas extras são lógicas de modelo que agora residem no aplicativo.
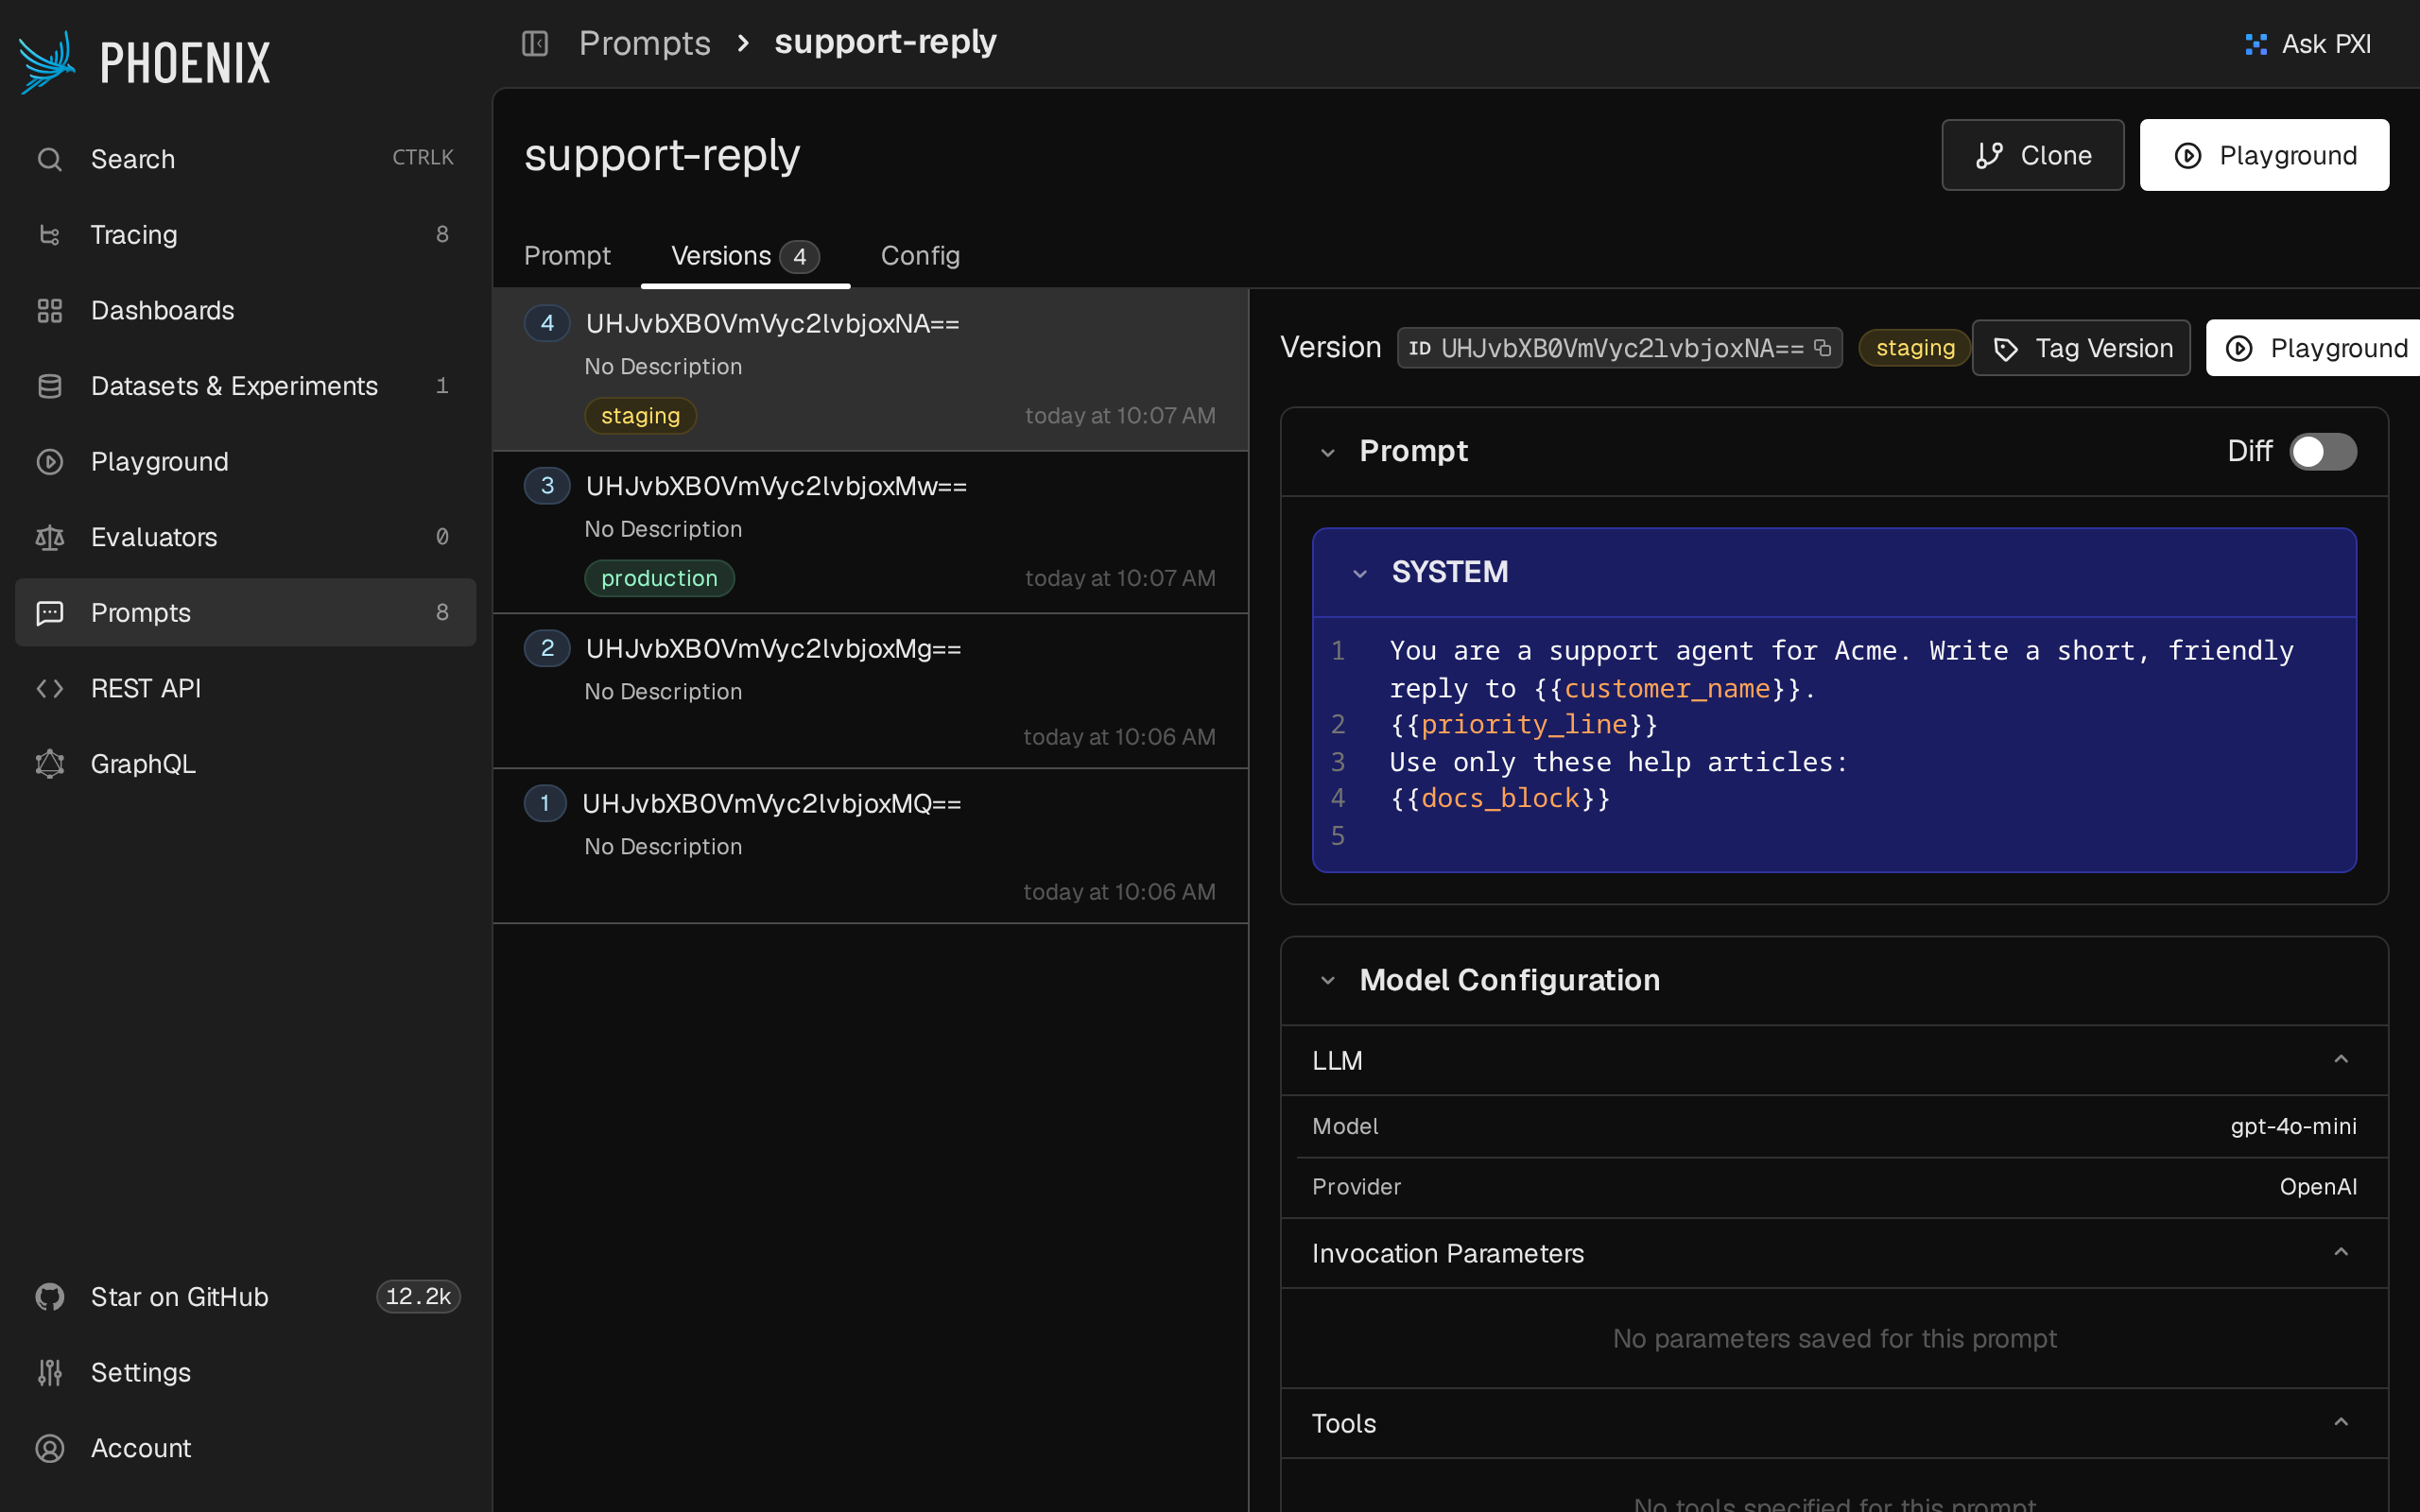
Modelos. Ofertas de Fênix MUSTACHE, F_STRING e NONE formatos (Referência de prompts). Mesmo em MUSTACHE modo, porém, a renderização é uma substituição simples de {{name}}. Quando enviamos seções de bigode, elas voltaram inalteradas, sem erros.
Erros. getPrompt() captura todos os erros, registra-os e retorna null. Você pode ver isso na fonte do cliente, src/utils/getPromptBySelector.ts. Um prompt ausente e um servidor inacessível têm a mesma aparência no seu código, e é por isso que o snippet verifica se há null.
Tamanho e cache. O cliente instalou 57 pacotes e 90 MB. A maior parte disso é OpenTelemetry, que vem através de seu @arizeai/phoenix-otel dependência. O cliente não possui cache de prompt, portanto, cada renderização é uma chamada de rede. É também por isso que uma mudança de rótulo apareceu imediatamente: 0 segundos em nosso teste.
AcruxCore: Jinja2, renderizado no servidor
AcruxCore armazena modelos Jinja2 e os renderiza no servidor com nunjucks. O SDK envia as variáveis e recebe de volta as mensagens finalizadas:
import { acruxcore } from "@acruxcoreai/sdk";

const hub = new acruxcore();

export async function systemPrompt(vars: Vars): Promise<string> {
  const { messages } = await hub.prompts.render("support-reply", "production", { ...vars });
  return messages(0).content as string;
}
O modelo da seção de teste funciona como está, condição e loop incluídos, sem is_premium sinalizador calculado em código. Um rótulo é chamado de alias aqui e promoteAlias() move-o (Gerenciar prompts por meio do SDK). O SDK instalou 3 pacotes e 12 MB. A maior parte dos 12 MB é um pacote OpenTelemetry, @opentelemetry/semantic-conventions.
Modelos. Apenas Jinja2. Quando fizemos o commit da versão bigode, o AcruxCore a rejeitou no momento do commit com Template parse error: unexpected token: #. Esse é um erro claro, mas também significa que mover os prompts de bigode do LangSmith ou do Langfuse exige reescrevê-los.
Limitações que atingimos.
- Cada novo conjunto de variáveis é uma chamada de rede. A renderização acontece no servidor. O cache de 60 segundos do SDK também é baseado nas variáveis, de acordo com a fonte do SDK. Portanto, uma solicitação com variáveis que o aplicativo não enviou antes sempre vai para o servidor, mesmo quando o modelo não foi alterado. Um Langfuse
compile()é executado localmente quando o prompt é armazenado em cache. - A hora de ver uma mudança foi de 62 segundos, o mesmo que Langfuse.
Lógica de modelo, comparada
Enviamos os mesmos dois templates, um Jinja2 e um bigode, para o renderizador de cada ferramenta:
| Modelo | Lang Smith (TS) | Langfus | Fênix | AcruxCore |
|---|---|---|---|---|
Jinja2 {% if %} / {% for %} |
Erro na renderização | Tags deixadas na saída | Tags deixadas na saída | Renderiza corretamente |
Seções de bigode {{#…}} |
Renderiza corretamente | Renderiza corretamente (não documentado) | Tags deixadas na saída | Rejeitado no commit |
As linhas que mais importam são aquelas onde as tags foram deixadas na saída, porque essas falhas não produzem erros. O modelo recebe sintaxe de modelo bruta e o único sintoma é uma resposta estranha. Seja qual for a ferramenta que você escolher, teste um prompt com lógica antes de mover o resto.
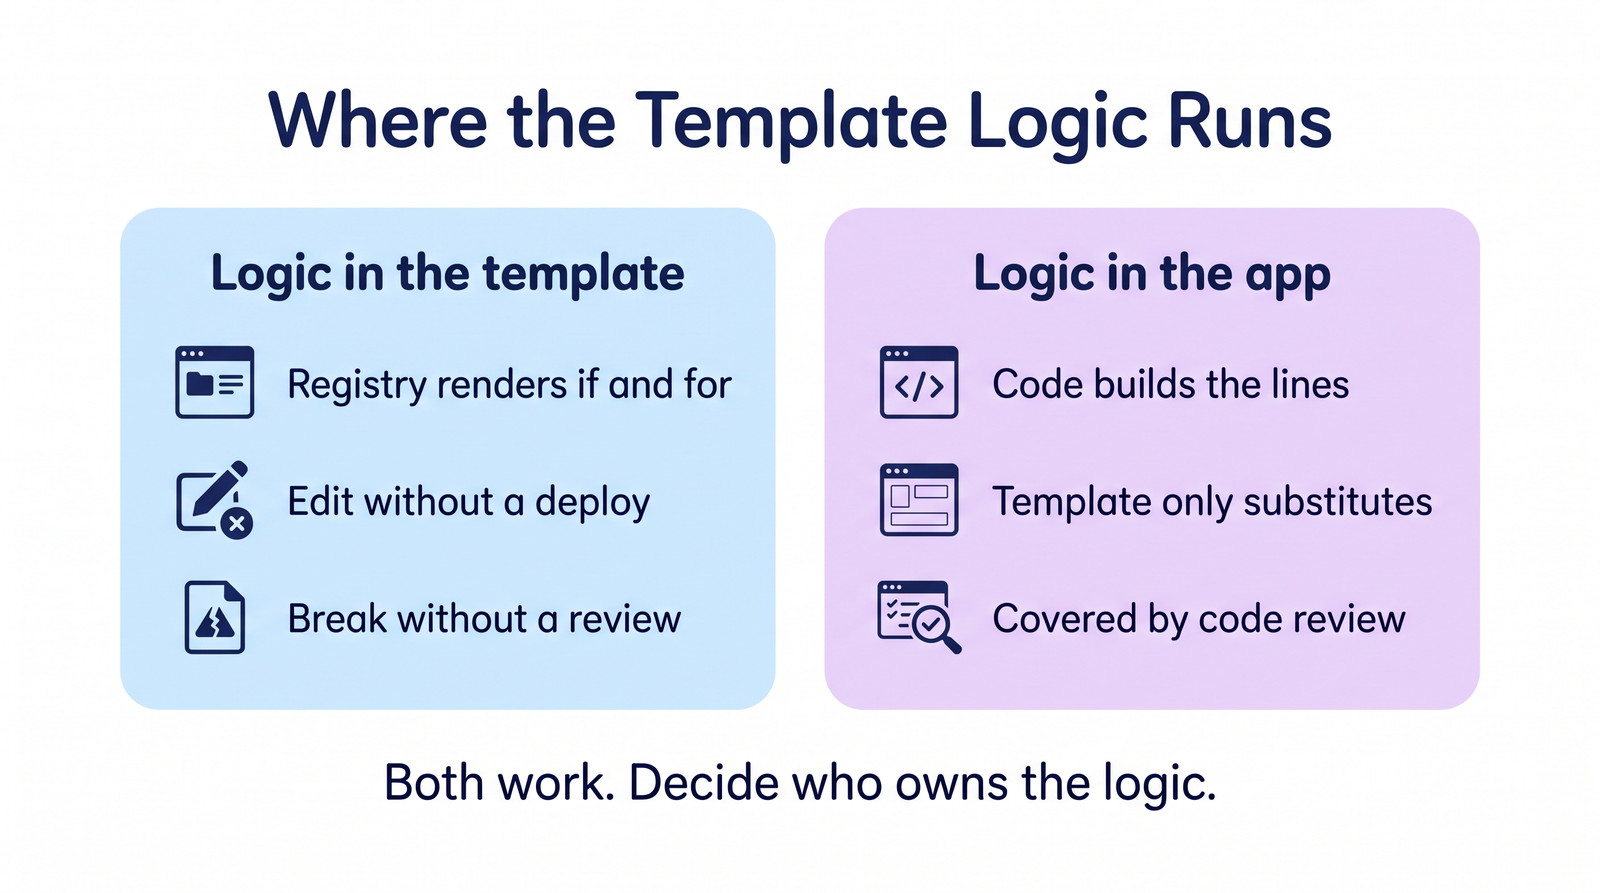
Colocar lógica no modelo não é automaticamente melhor. Permite que alguém altere a condição sem implantar. Também permite que eles quebrem a condição sem implantar. Manter a lógica no código, como o Phoenix obriga você a fazer, coloca cada ramificação sob revisão de código e em seus testes.
Quando o registro está inativo
Um registro é uma nova dependência de tempo de execução, por isso testamos uma interrupção. O aplicativo alcançou cada registro por meio de um proxy local e desligamos o proxy. Um processo separado foi iniciado enquanto o registro ainda estava inacessível.
| Para baixo, cache quente | Abaixo, além do tempo de cache | Novo processo, registro desativado | |
|---|---|---|---|
| Lang Smith | Serviu o prompt em cache | Serviu o prompt em cache | Jogou depois de 26 s |
| Langfus | Serviu o prompt em cache | Serviu o prompt em cache | Jogou; fallback retornou o prompt integrado |
| Fênix | Falha (sem cache) | Fracassado | Devolvido null |
| AcruxCore | Serviu o prompt em cache | Serviu o prompt em cache | Lançado após 0,6 s |
LangSmith, Langfuse e AcruxCore continuam servindo a última versão válida enquanto o registro está inativo, mesmo após o tempo de cache ter passado. O risco é uma inicialização a frio: um novo contêiner ou uma função sem servidor que inicializa durante a interrupção. Langfuse’s fallback opção é a resposta integrada para isso. Com as outras ferramentas, mantenha uma cópia de cada prompt em seu código como substituto, o que traz de volta parte da configuração do Git.
Qual você deve escolher?
Manter prompts no Git se os engenheiros fizerem todas as alterações imediatas e suas implantações forem rápidas. Definir autoescape: falsee você obtém Jinja2, comentários e histórico gratuitamente.
Use o hub de prompt do LangSmith se você já usa LangChain ou já rastreia com LangSmith. Se seu aplicativo não usa LangChain, faça um orçamento para a dependência extra e para as movimentações de tags que apenas a IU suporta.
Usar Langfuse se você quer um cliente pequeno, um local compile()e um substituto para partidas a frio. Mantenha-se em {{variable}} substituição, a menos que você se sinta confortável em confiar no comportamento do bigode que a documentação não promete.
Usar Fênix se você já o usa para rastreamento ou se prefere toda a lógica do modelo no código. Lembre-se do null verifique e que cada renderização é uma chamada de rede.
Usar AcruxCore se você deseja condições reais e loops no modelo e renderização no servidor. Espere uma chamada de rede por novo conjunto de variáveis e uma chave de API pessoal para gravações.
Antes de escolher, execute um de seus próprios prompts com lógica real por meio do SDK da ferramenta, não por meio de seu playground. Dois dos quatro registros que testamos falharam na sintaxe do modelo sem nenhum erro, e uma execução do SDK é onde você veria isso.
