


Você construiu um agente. Planeja bem, chama as ferramentas em uma ordem sensata e escreve um resumo decente. Então você aponta para um URL real e ele volta com um resumo de uma página de desafio da Cloudflare, um banner de cookie ou nada.
Esta é a parte menos glamorosa da construção com LLMs e é onde muitos projetos de agentes fracassam silenciosamente. O modelo raramente é o problema. A busca é. Neste artigo, veremos por que a recuperação ao vivo da web se tornou tão pouco confiável para ferramentas de IA, o que os números dizem sobre a mudança e como construir uma camada de busca pequena e bem comportada em Python que falha ruidosamente em vez de alimentar seu modelo com lixo.
Principais conclusões
- O tráfego automatizado ultrapassou o tráfego humano na web em 2024, e os proprietários de sites responderam bloqueando os bots de forma mais agressiva.
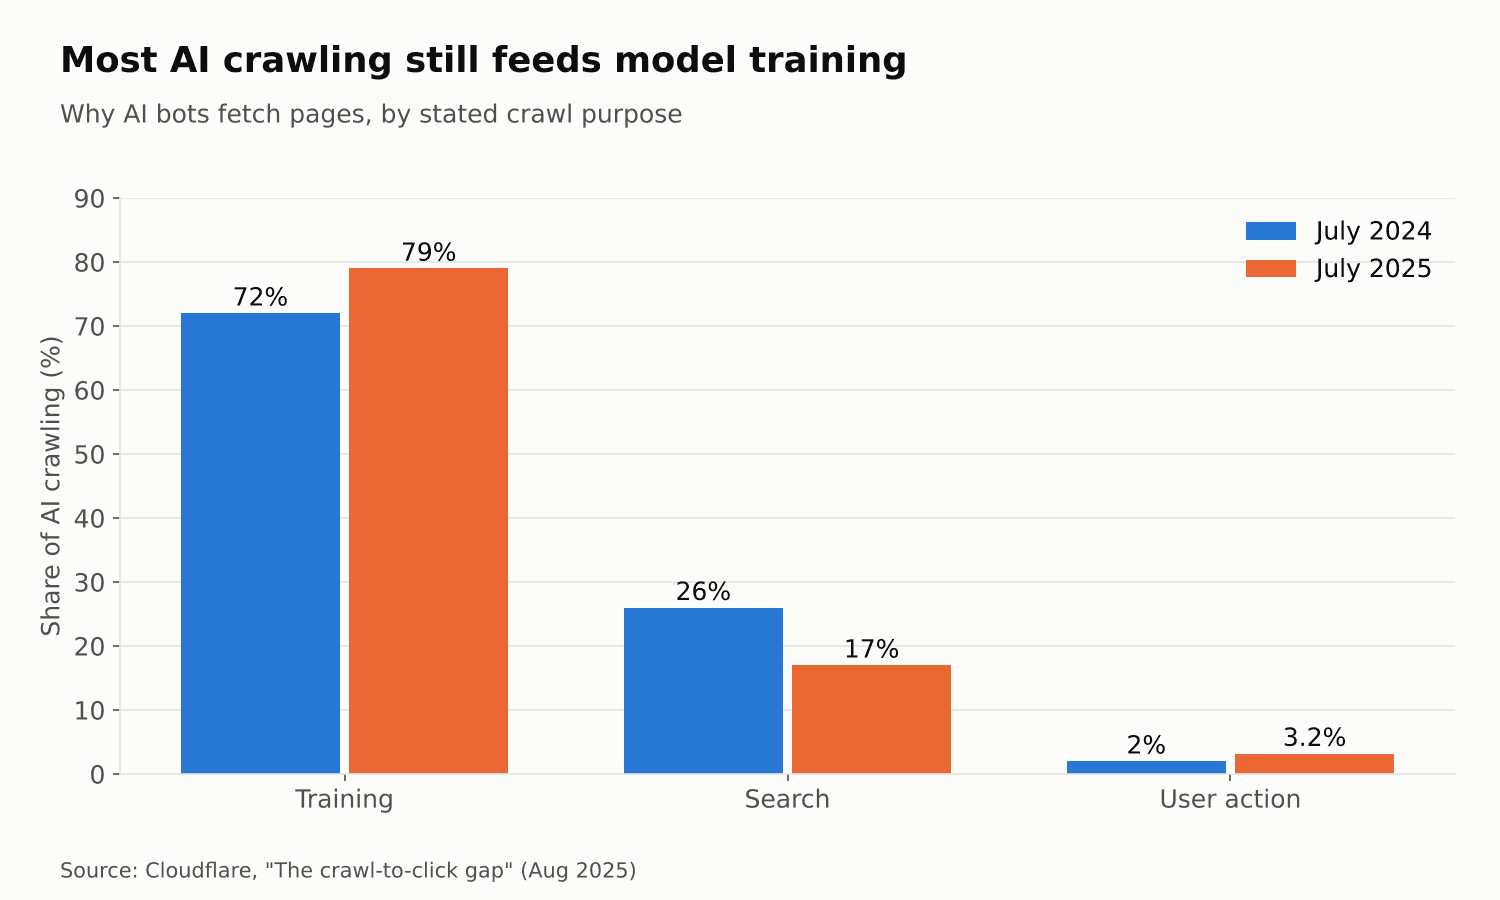
- A maior parte do rastreamento de IA ainda é para treinamento de modelo, e é por isso que muitos sites agora bloqueiam agentes de usuários de IA à primeira vista, incluindo aqueles que buscam páginas para um usuário real.
- Uma boa camada de busca verifica o robots.txt, identifica-se honestamente, classifica as falhas em tipos, tenta novamente com espera e armazena em cache o que já possui.
- O bug mais comum do agente é tratar uma página bloqueada como conteúdo. Detecte-o e falhe ruidosamente.
A Web mudou sob os pés do seu agente
Há alguns anos, uma planície requests.get() trabalhou na maior parte da web pública. Isso não é mais verdade, e a razão é simples: agora existem mais bots do que pessoas.
De acordo com o Relatório de bots ruins da Imperva 2025o tráfego automatizado representou 51% de todo o tráfego da web em 2024. É a primeira vez em uma década que ele ultrapassa a atividade humana. Somente os bots ruins (scrapers, credential stuffers, scalpers) passaram de 32% para 37% do tráfego em um único ano.
Fonte: Relatório Bad Boat da Imperva
Do ponto de vista do proprietário de um site, seu educado agente de pesquisa e um botnet de preenchimento de credenciais parecem iguais na borda da rede. Ambos são clientes que não são navegadores e fazem solicitações rápidas de intervalos de IP do data center. Portanto, os padrões ficaram mais rígidos. Em julho de 2025, a Cloudflare começou a bloquear rastreadores de IA conhecidos por padrão para novos clientes, e os produtos de gerenciamento de bots agora analisam impressões digitais TLS, ordem de cabeçalho, reputação de IP e execução de JavaScript, não apenas a string User-Agent.
Por que os AI Bots em particular são bloqueados
Ajuda a entender o lado do editor no negócio, porque explica por que seu agente está sendo tratado com suspeita.
A Cloudflare divide o rastreamento de IA em três propósitos: treinamento (coleta de dados para treinar modelos), procurar (construindo um índice para respostas de pesquisa de IA) e ação do usuário (buscando uma página porque uma pessoa acabou de fazer uma pergunta). O treinamento domina.
Fonte: Cloudflare
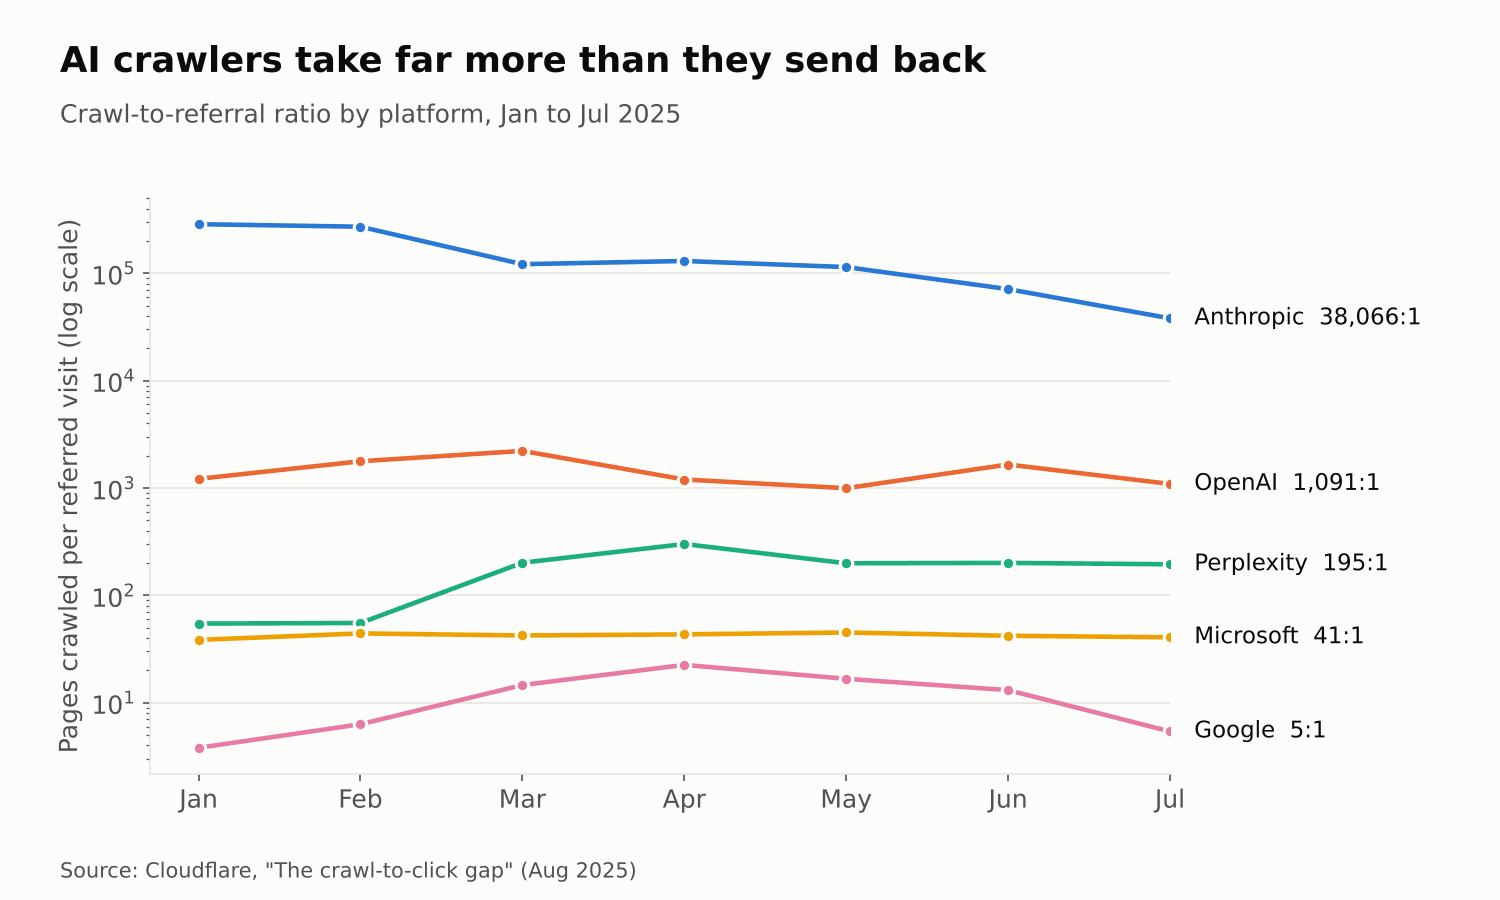
Os rastreamentos de treinamento pegam o conteúdo e não enviam nada de volta. A Cloudflare mede isso com um proporção de rastreamento para referência: quantas páginas uma plataforma rastreia para cada visitante que envia ao site. Em seu análise de lacunas do rastreamento para clicaras proporções para algumas plataformas de IA chegaram a dezenas de milhares, em comparação com um dígito para a pesquisa tradicional.
Fonte: Cloudflare
Se você publicasse uma publicação e visse esses números, também bloquearia. O problema é que o bloqueio geralmente é feito pelo agente do usuário ou intervalo de IP, então ele atinge ação do usuário busca também. São aqueles que acontecem quando uma pessoa pede ao seu agente para ler um artigo específico, e o da Cloudflare Análise do ano de 2025 descobriram que cresceram mais de 15 vezes durante o ano. Seu agente está envolvido em uma briga que não começou.
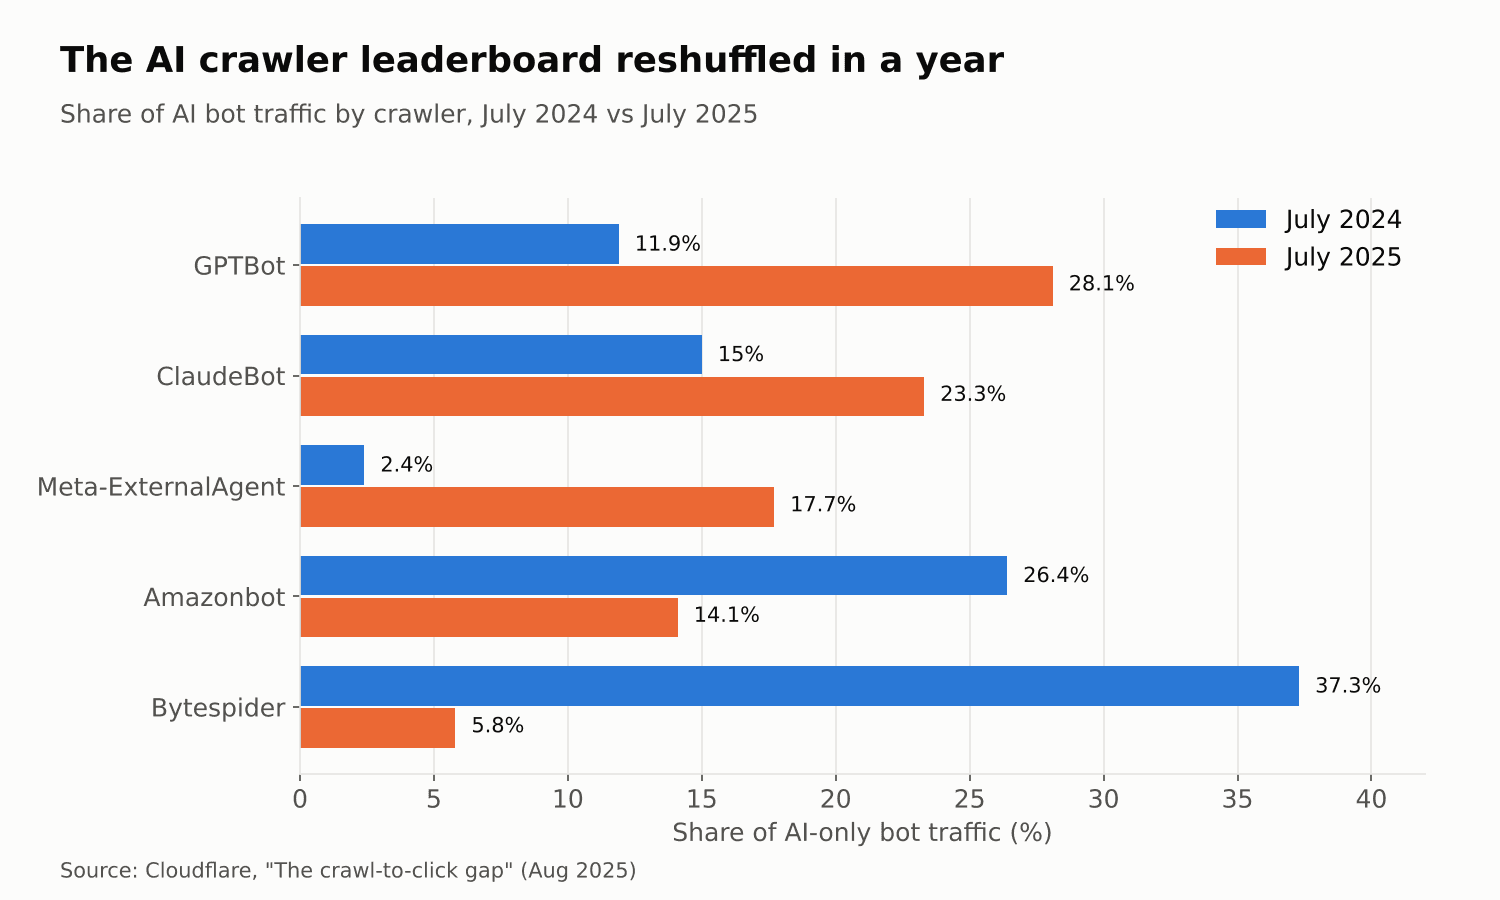
A combinação de rastreadores também muda rapidamente, o que torna as listas estáticas de permissões e bloqueios frágeis em ambos os lados:
Fonte: Cloudflare
E as restrições continuam se acumulando. O Consentimento em crise O estudo auditou 14.000 domínios da web e descobriu que uma parcela grande e em rápido crescimento das fontes por trás do corpus de treinamento C4 agora restringe os rastreadores de IA, seja por meio do robots.txt ou de seus termos de serviço.
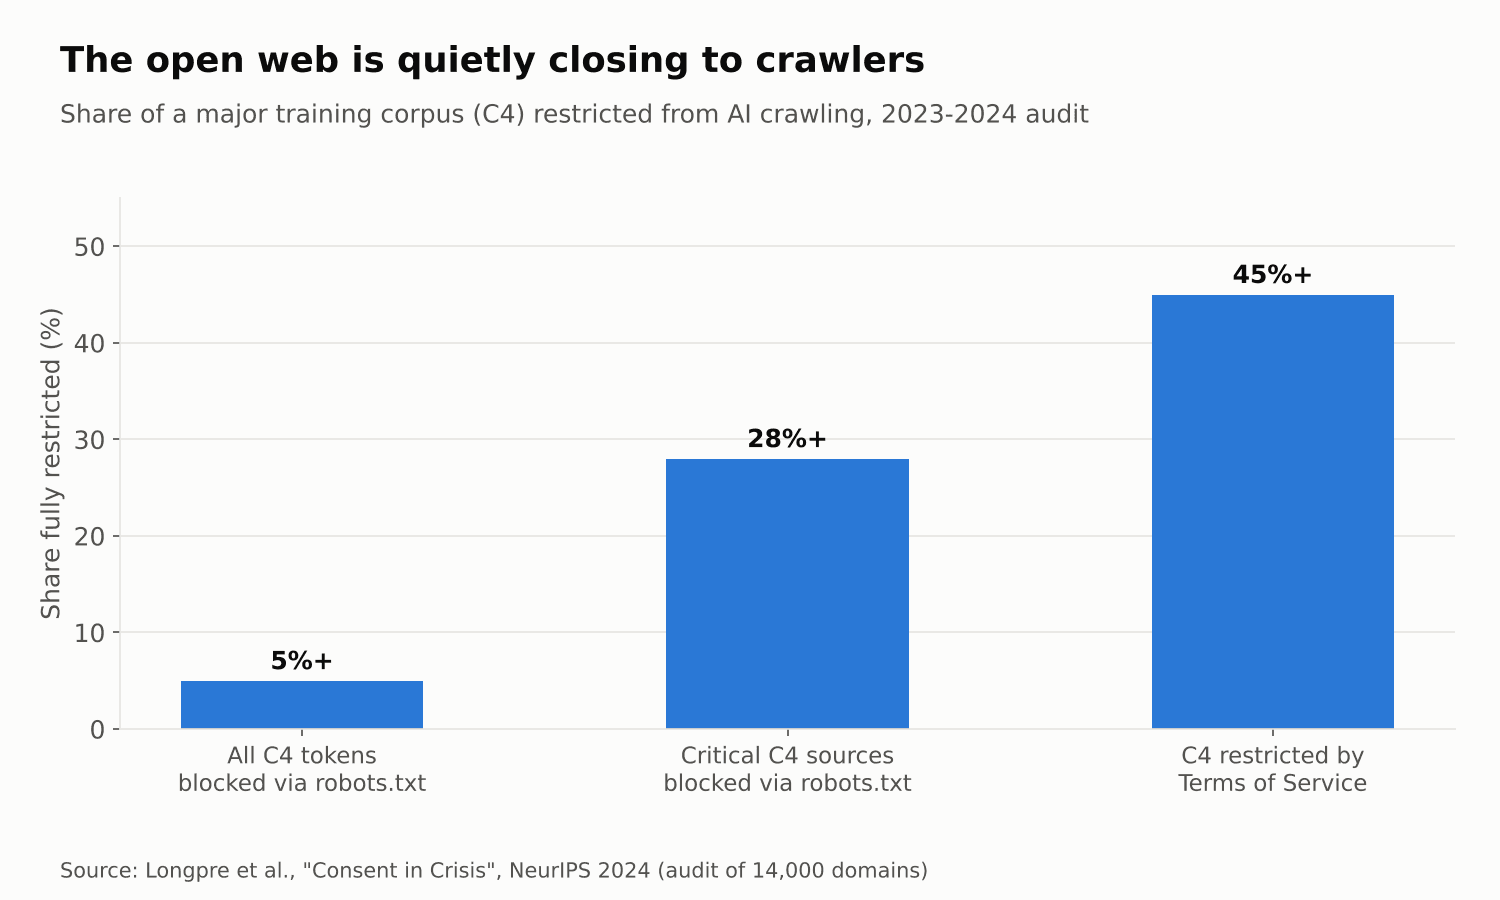
Fonte: Longpre et al., Consentimento em Crise (NeurIPS 2024)
Então esse é o ambiente que seu agente busca. Veja como construir para isso.
As quatro maneiras pelas quais uma busca falha
Antes de escrever qualquer lógica de nova tentativa, coloque nomes em suas falhas. “A solicitação falhou” é inútil para você e para o modelo. Na prática, quase todas as buscas com falha caem em um dos quatro grupos:
- Não é permitido. O robots.txt não permite o seu agente ou os termos do site proíbem o acesso automatizado. A resposta correta é parar e informar o usuário. Não tente novamente.
- Bloqueado. HTTP 403, uma página de desafio ou uma resposta 200 cujo corpo é na verdade um intersticial “verifique se você é humano”. Tentar novamente imediatamente não ajudará.
- Estrangulado. HTTP 429 ou 503, geralmente com um
Retry-Aftercabeçalho. Recue e tente novamente mais tarde. - Quebrado. Erros de DNS, tempos limite, redefinições de conexão, erros 5xx. Muitas vezes, são temporários, portanto, tente novamente algumas vezes.
O intervalo 2 é perigoso, porque uma página de bloqueio geralmente volta com um 200 OK. Se você não marcar, o modelo resumirá alegremente “Verificando seu navegador antes de acessar…” como se fosse o artigo.
Construindo a camada de busca
Aqui está uma camada de busca compacta em Python usando httpx e o analisador robots.txt da biblioteca padrão. Tem cerca de 100 linhas e cobre os quatro grupos acima.
Etapa 1: identifique-se honestamente e respeite o robots.txt
Use um agente de usuário descritivo com um URL de contato. Não custa nada e os operadores do site têm muito mais probabilidade de permitir um cliente que possam identificar e alcançar. Em seguida, verifique robots.txt (padronizado como RFC 9309) antes de cada novo host.
import time
import httpx
from functools import lru_cache
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser

USER_AGENT = "AcmeResearchAgent/1.0 (+https://example.com/bot)"

@lru_cache(maxsize=512)
def robots_for(origin: str) -> RobotFileParser:
    rp = RobotFileParser()
    try:
        r = httpx.get(f"{origin}/robots.txt", headers={"User-Agent": USER_AGENT},
                      timeout=5, follow_redirects=True)
        if r.status_code in (401, 403):
            rp.disallow_all = True
        elif r.status_code >= 400:
            rp.allow_all = True
        else:
            rp.parse(r.text.splitlines())
    except httpx.HTTPError:
        rp.allow_all = True
    return rp

def allowed(url: str) -> bool:
    parts = urlsplit(url)
    origin = f"{parts.scheme}://{parts.netloc}"
    return robots_for(origin).can_fetch(USER_AGENT, url)
O lru_cache significa que você busca o robots.txt uma vez por origem, em vez de uma vez por página. Em um serviço de longa duração, você desejará um cache com TTL, pois os arquivos robots.txt mudam.
Etapa 2: classifique cada resposta
Este é o núcleo da camada. Em vez de retornar HTML bruto, retorne um resultado que indique em qual bucket você acessou.
from dataclasses import dataclass

BLOCK_MARKERS = (
    "cf-chl-",
    "verify you are human",
    "checking your browser",
    "enable javascript and cookies",
    "access denied",
)

@dataclass
class FetchResult:
    status: str
    url: str
    text: str = ""
    detail: str = ""
    retry_after: float | None = None

def looks_blocked(resp: httpx.Response) -> bool:
    if resp.status_code == 403:
        return True
    ctype = resp.headers.get("content-type", "")
    if "text/html" not in ctype:
        return False
    head = resp.text(:5000).lower()
    return any(marker in head for marker in BLOCK_MARKERS)

def classify(url: str, resp: httpx.Response) -> FetchResult:
    if resp.status_code in (429, 503):
        ra = resp.headers.get("retry-after")
        wait = float(ra) if ra and ra.isdigit() else None
        return FetchResult("throttled", url, detail=str(resp.status_code), retry_after=wait)
    if looks_blocked(resp):
        return FetchResult("blocked", url, detail=f"HTTP {resp.status_code}")
    if resp.status_code >= 400:
        return FetchResult("broken", url, detail=f"HTTP {resp.status_code}")
    return FetchResult("ok", url, text=resp.text)
A lista de marcadores é deliberadamente simples. Ele não captura todos os intersticiais, mas captura os mais comuns, e um falso “bloqueado” é muito mais barato do que um resumo confiável de uma página CAPTCHA. Registre cada resultado bloqueado com suas primeiras centenas de caracteres para que você possa aumentar a lista a partir de dados reais.
Etapa 3: tente novamente apenas o que vale a pena tentar novamente
As novas tentativas devem depender do intervalo. Respostas limitadas e interrompidas obtêm uma espera exponencial com jitter. As respostas bloqueadas e não permitidas não geram nenhuma nova tentativa.
import random

def fetch(url: str, max_attempts: int = 3) -> FetchResult:
    if not allowed(url):
        return FetchResult("not_allowed", url, detail="Disallowed by robots.txt")

    delay = 1.0
    last = FetchResult("broken", url, detail="no attempt made")
    with httpx.Client(headers={"User-Agent": USER_AGENT},
                      timeout=httpx.Timeout(10.0, connect=5.0),
                      follow_redirects=True) as client:
        for attempt in range(max_attempts):
            try:
                result = classify(url, client.get(url))
            except httpx.HTTPError as exc:
                result = FetchResult("broken", url, detail=type(exc).__name__)

            if result.status in ("ok", "blocked", "not_allowed"):
                return result

            last = result
            wait = result.retry_after or delay + random.uniform(0, delay)
            time.sleep(min(wait, 30))
            delay *= 2
    return last
Observe a tampa wait. Um site enviando Retry-After: 3600 está dizendo para você ir embora por uma hora. Um agente interativo deve relatar isso ao usuário, em vez de bloquear um thread de solicitação por tanto tempo.
Etapa 4: cache com solicitações condicionais
A busca mais barata é aquela que você não faz. Os agentes costumam reler a mesma página de documentação diversas vezes em uma sessão. Armazene o ETag e Last-Modified cabeçalhos e enviá-los de volta como If-None-Match e If-Modified-Since. UM 304 Not Modified a resposta não custa quase nada ao servidor e reduz as chances de ter taxa limitada.
_cache: dict(str, tuple(dict, str)) = {}

def conditional_headers(url: str) -> dict:
    if url not in _cache:
        return {}
    meta, _ = _cache(url)
    h = {}
    if "etag" in meta:
        h("If-None-Match") = meta("etag")
    if "last-modified" in meta:
        h("If-Modified-Since") = meta("last-modified")
    return h

def remember(url: str, resp: httpx.Response) -> None:
    meta = {k: resp.headers(k) for k in ("etag", "last-modified") if k in resp.headers}
    if meta:
        _cache(url) = (meta, resp.text)
Conecte-os em fetch() passando headers=conditional_headers(url) para client.get(). Em um 304, retorne o texto armazenado em cache. Em um 200, ligue remember().
Etapa 5: conte ao modelo o que aconteceu
Finalmente, não esconda as falhas do LLM. Dê à saída da ferramenta uma forma estruturada para que o modelo possa raciocinar sobre ela:
def fetch_tool(url: str) -> dict:
    r = fetch(url)
    if r.status == "ok":
        return {"ok": True, "url": url, "content": extract_main_text(r.text)}
    return {
        "ok": False,
        "url": url,
        "reason": r.status,
        "detail": r.detail,
        "hint": {
            "not_allowed": "The site does not permit automated access. Tell the user.",
            "blocked": "The site blocked this request. Try an official API or another source.",
            "throttled": "The site is rate limiting. Try again later or use a cached source.",
            "broken": "The site could not be reached. It may be down.",
        }(r.status),
    }
(extract_main_text é qualquer etapa de legibilidade ou remoção de padrão que você já usa. Bibliotecas como trafilatura funciona bem aqui.)
Com isso implementado, a resposta do modelo muda de um resumo inventado para “Não consegui ler aquela página porque o site bloqueia o acesso automatizado. Aqui está o que descobri em duas outras fontes”. Esse é um produto melhor e constrói a confiança dos usuários.
E as páginas que você ainda não consegue acessar?
Depois de fazer tudo acima, algumas buscas legítimas de ações do usuário ainda falharão. Geralmente, isso ocorre porque o site bloqueia completamente os intervalos de IP do data center, e não por causa de algo que seu agente fez. As equipes lidam com isso de algumas maneiras, aproximadamente em ordem de preferência:
- Use a API ou feed oficial. RSS, mapas de sites, APIs públicas e exportações de documentação são mais rápidos, mais estáveis e claramente sancionados.
- Solicite acesso. Muitos editores permitirão um bot claramente identificado com um endereço de contato real, especialmente para buscas de baixo volume acionadas pelo usuário.
- Use uma API de pesquisa ou recuperação que já possui acordos de licenciamento com editoras.
- Rotear através de uma rede residencial ou de consumo. Esta é a opção mais contestada, e a forma como uma rede obtém seus IPs é muito importante. Alguns pools de proxy foram historicamente construídos a partir de dispositivos cujos proprietários nunca concordaram conscientemente em compartilhá-los. Em vez disso, um grupo mais recente de provedores é baseado no consentimento. Por exemplo, Bixberry administra uma rede opcional onde as pessoas instalam um aplicativo, optam por compartilhar largura de banda extra para pesquisas de assistente de IA e ganham recompensas por isso. Se você seguir esse caminho, verifique como o provedor obtém o consentimento, que tráfego ele permite e se ainda respeita o robots.txt e os termos do site. Um IP residencial não torna aceitável a busca de uma página que o proprietário do site tenha explicitamente proibido.
O princípio é o mesmo em todos os casos: o caminho da rede é uma decisão de confiabilidade, não uma forma de contornar os desejos de um site. Sua verificação do robots.txt e seu agente de usuário honesto devem permanecer em vigor, independentemente do caminho que a solicitação seguir.
Monitoramento: os números que valem a pena acompanhar
Depois que sua camada de busca retornar resultados estruturados, a observabilidade será fácil. Emita um evento por busca com o host, bucket de status e latência e observe estes:
- Taxa de sucesso por host. Uma queda repentina de um domínio geralmente significa que as regras do bot foram alteradas.
- Taxa bloqueada em geral. Se isso ocorrer em muitos hosts, verifique se seu intervalo de IP ou impressão digital TLS foi sinalizado.
- Taxa de acerto do cache. Uma taxa baixa em um agente estilo chat geralmente significa que a chave do cache está errada (por exemplo, strings de consulta ou barras finais).
- Taxa “O conteúdo parecia uma página de bloqueio”. Isso informa com que frequência você teria alimentado o modelo com lixo sem a verificação.
Se você estiver prototipando agentes com assistentes de codificação de IA, peça-lhes que gerem esses ganchos de métricas desde o início. Eles são fáceis de instalar agora e difíceis de adicionar mais tarde. Para ter uma ideia de quão bem as ferramentas atuais lidam com esse tipo de código de infraestrutura, Diário do codificador Vibe publica análises práticas e benchmarks de ferramentas de codificação de IA.
Uma lista de verificação rápida
- User-Agent descritivo com URL de contato
- robots.txt verificado e armazenado em cache por origem
- Respostas classificadas em ok / not_allowed / bloqueadas / limitadas / quebradas
- Bloquear páginas detectadas mesmo quando o status é 200
- Backoff exponencial com jitter apenas para estrangulados e quebrados, com limite de espera
- Solicitações condicionais com ETag e última modificação
- Saída de ferramenta estruturada para que o modelo possa explicar falhas
- Métricas por host sobre sucesso, taxas de bloqueio e cache
Concluindo
A web que seu agente lê em 2026 não é a web aberta e acessível que muitos de nós aprendemos. Mais da metade do tráfego é automatizado, os editores têm bons motivos para desconfiar dos rastreadores de IA e os padrões agora tendem ao bloqueio. Você não pode mudar isso. Porém, você pode fazer do seu agente um bom cidadão: alguém que se identifica, respeita as regras, recua quando solicitado e diz a verdade quando não consegue ler alguma coisa.
A maior parte dos ganhos de confiabilidade vem de partes nada glamorosas: classificação de falhas, armazenamento em cache e passagem de erros honestos para o modelo. Faça tudo certo e seu agente se sentirá muito mais confiável, mesmo nos dias em que metade da web não o deixará entrar.
Perguntas frequentes
É legal para um agente de IA buscar páginas da web?
Depende da jurisdição, dos termos de serviço do site e do que você faz com o conteúdo. Respeitar o robots.txt e os termos do site é a linha de base. Para produtos comerciais, obtenha aconselhamento jurídico adequado.
Meu agente deve obedecer ao robots.txt para buscas acionadas pelo usuário?
Muitos proprietários de sites esperam que isso aconteça, e a RFC 9309 não faz exceção para buscas acionadas pelo usuário. O padrão mais seguro é obedecê-lo e informar ao usuário quando uma página não é permitida.
Por que minha busca retorna 200 mas o conteúdo é inútil?
Muitos sistemas de proteção contra bots oferecem uma página de desafio com status 200. Verifique se há marcadores de desafio no corpo antes de passá-lo para o modelo, como no looks_blocked() função acima.
Eu preciso de um navegador sem cabeça?
Somente para páginas que renderizam seu conteúdo principal com JavaScript. Tente primeiro uma busca HTTP simples. Os navegadores sem cabeça são mais lentos, custam mais para serem executados e são mais fáceis de identificar.
